În ultima mea postare despre permutam-am uitat la seturi de partiții ordonate și noua interfață de formulă pentru parcele și blocuri. De data aceasta vreau să arăt doi asistenți pentru următoarea parte a scrierii unui test de permutare: luând acele permutări și faceți ceva cu ele.
permutations() vă oferă direct valorile amestecate. permutator() vă oferă o funcție care distribuie următorul set de indici de observație de fiecare dată când îl apelați. Ambele folosesc aceeași mașinărie de permutare dedesubt, așa că le putem folosi pentru a construi același test în două moduri ușor diferite.
Aceste funcții sunt în versiunea de dezvoltare a permutei. Pentru a urma, instalează-l din universul meu R:
install.packages("permute", repos = c(
  "https://gavinsimpson.r-universe.dev",
  "https://cloud.r-project.org"
))
Ceva diferit de șacali
Să folosim PlantGrowthcare vine cu R. Înregistrează greutățile plantelor uscate sub un control și două condiții de tratament:
library("permute")
data(PlantGrowth, package = "datasets")

aggregate(weight ~ group, data = PlantGrowth, FUN = mean)
  group weight
1  ctrl  5.032
2  trt1  4.661
3  trt2  5.526
Mijloacele grupului diferă, dar este aceasta mai multă variație decât ne-am aștepta dacă greutatea plantelor nu ar fi legată de tratamente? Putem folosi statistica generală F dintr-un model liniar pentru a măsura cât de diferite sunt grupurile. Valorile mai mari înseamnă mai multă variație între grupuri în raport cu variația în interiorul acestora.
Voi încheia acel calcul într-o funcție mică, pentru că o vom face de câteva ori:
f_stat <- function(weight, group) {
  fit <- lm(weight ~ group)
  unname(summary(fit)$fstatistic(("value")))
}

observed <- with(PlantGrowth, f_stat(weight, group))
observed
Acesta este un test general pentru grupuri. Nu ne spune ce tratamente particulare diferă.
Pentru testul de permutare, vom lăsa etichetele grupului pe loc și vom amesteca greutățile între ele. În conformitate cu ipoteza nulă, presupunem că acele ponderi sunt schimbabile între grupurile de tratament.
Dă-mi valorile amestecate
De obicei, shuffleSet() revine permutate indicipe care apoi îl folosim pentru a ne rearanja datele. permutations() face acel pas de indexare pentru noi:
ctrl <- how(nperm = 9999)

set.seed(42)
shuffled <- permutations(PlantGrowth$weight, control = ctrl)

dim(shuffled)
Fiecare rând conține o versiune amestecată a vectorului de greutate. Coloanele corespund pozițiilor inițiale de observare, așa că putem asocia fiecare rând cu cel neschimbat PlantGrowth$group vector. Iată primele valori din câteva rânduri:
as.matrix(shuffled)(seq_len(3), seq_len(5))
     (,1) (,2) (,3) (,4) (,5)
(1,) 6.03 4.50 4.17 5.37 5.14
(2,) 4.81 5.87 5.12 5.29 4.53
(3,) 5.14 4.53 4.50 4.17 6.03
Acestea sunt greutăți de plante, gata de utilizare. as.matrix() elimină doar metadatele de permutare suplimentare pentru acest mic aspect.
Acum potriviți modelul pentru fiecare rând în shuffled și colectați statisticile F:
null_values <- apply(shuffled, 1, f_stat, group = PlantGrowth$group)
Aceasta este distribuția noastră de permutare. The  -valoarea este proporția de rezultate cel puțin la fel de mare ca statistica F observată, inclusiv rezultatul observat în sine:
tol <- sqrt(.Machine$double.eps)
p_value <- (1 + sum(null_values >= observed - tol)) /
  (length(null_values) + 1)

c(F = observed, p_value = p_value)
       F  p_value
4.846088 0.014200
Toleranța mică ne permite să numărăm legăturile în ciuda diferențelor numerice minore în potrivirile modelului. Adăugarea unuia la numărător și numitor include statistica observată în acest test Monte Carlo. Numărăm coada superioară deoarece statisticile F mai mari sunt mai extreme; nu este nevoie să dublezi rezultatul pentru un test al diferențelor în ambele direcții.
De asemenea, putem arunca o privire asupra datelor și distribuției de permutare:
old_par <- par(mfrow = c(1, 2))
boxplot(weight ~ group, data = PlantGrowth,
        xlab = "Group", ylab = "Dried plant weight",
        col = "grey85")
hist(null_values, breaks = 40, main = "",
     xlab = "F statistic after shuffling weights",
     col = "grey85", border = "white")
abline(v = observed, col = "firebrick", lwd = 2)
par(old_par)

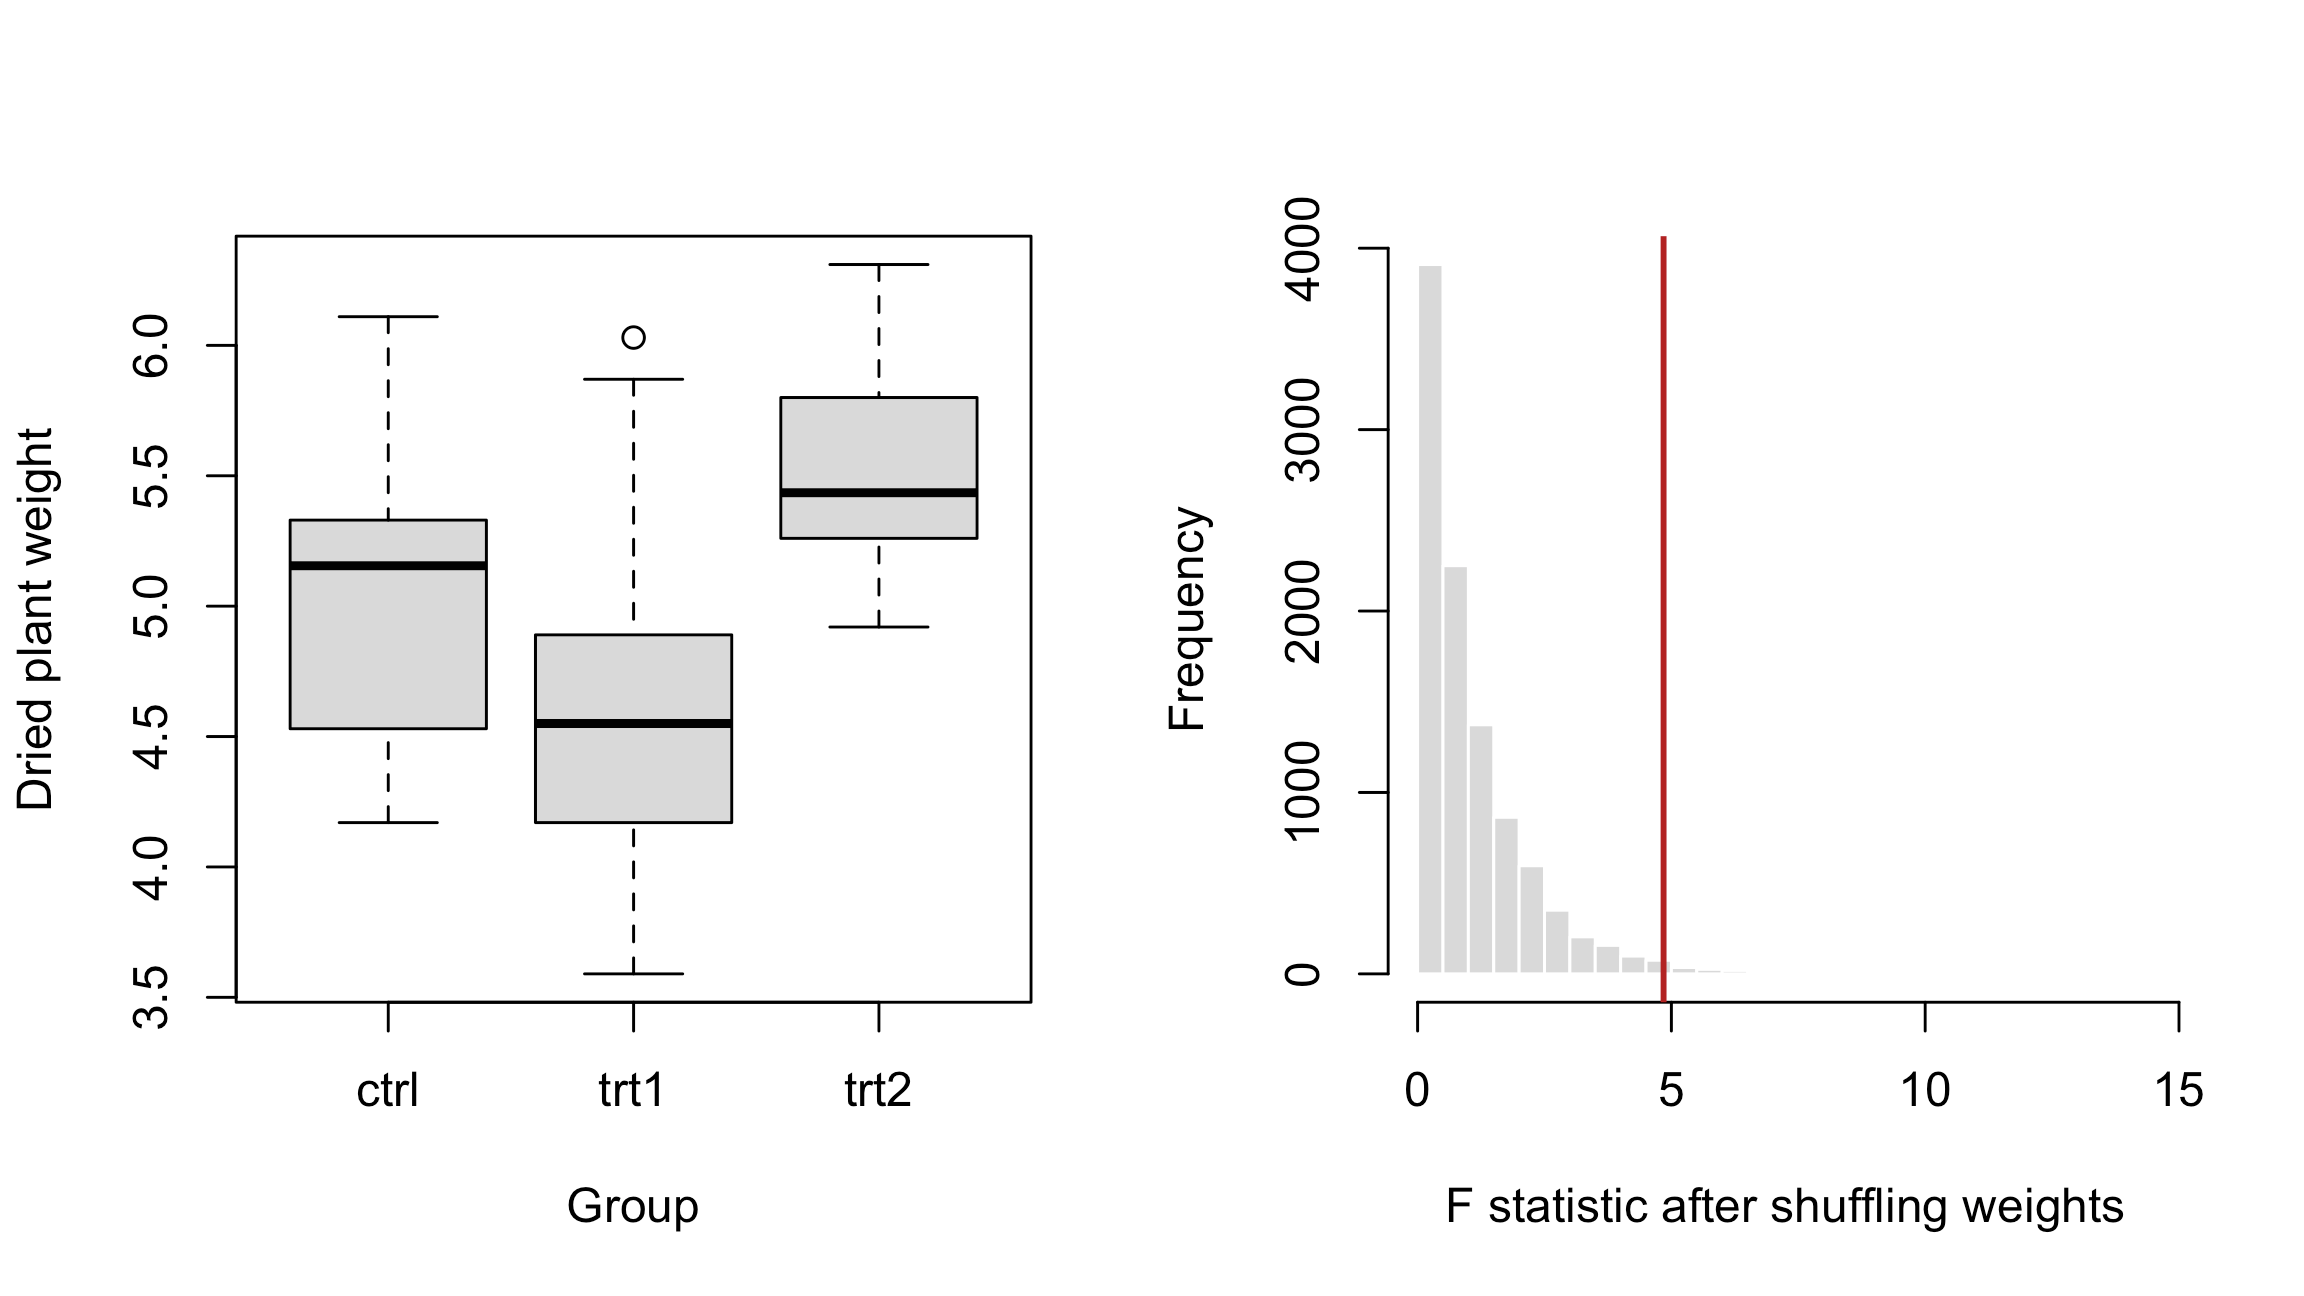
Valoarea observată se află în coada dreaptă. Pentru acest test de permutare nerestricționat, există dovezi ale diferențelor între grupurile de tratament. Valoarea p este estimată din permutări aleatorii, așa că va varia în funcție de sămânța și numărul pe care îl solicităm.
permutations() funcționează cu un vector atomic, mai degrabă decât cu un întreg cadru de date. Dacă îi dați un factor, returnează etichetele de caractere amestecate. De asemenea, urmează obișnuitul shuffleSet() reguli privind verificarea și enumerarea completă, astfel încât numărul de rânduri returnate poate diferi de numărul cerut pentru spații mici de permutare. Utilizați dimensiunea obiectului returnat în calculele ulterioare, așa cum am făcut mai sus.
O permutare la un moment dat
Uneori o buclă1 este un loc mai convenabil pentru a potrivi un model, pentru a colecta mai multe rezultate sau pentru a urmări progresul. Aceasta este o situație în care permutator() intră.
Apelarea acestuia creează o funcție. Apel că funcția returnează următoarea permutare a indicilor de observație. Voi reseta sămânța, astfel încât să folosim același set pe care l-am folosit mai sus:
set.seed(42)
next_perm <- permutator(nrow(PlantGrowth), control = ctrl)

null_iter <- numeric(attr(next_perm, "nperm"))

for (b in seq_along(null_iter)) {
  i <- next_perm()
  null_iter(b) <- f_stat(PlantGrowth$weight(i), PlantGrowth$group)
}
Aici i conţine indici, deci PlantGrowth$weight(i) face amestecul. Al iteratorului "nperm" atributul ne spune câte permutări sunt de fapt în set; folosim asta pentru a aloca vectorul de rezultate.
După ce am folosit toate permutările, se întoarce un alt apel NULL:
Un iterator își amintește cât de departe ai ajuns. Dacă rulați din nou bucla cu acest iterator epuizat, nu va începe de la capăt; mai întâi creați unul proaspăt.
Cele două abordări ne-au oferit aceleași statistici F?
all.equal(null_values, null_iter)
Au făcut-o. Am resetat sămânța și am folosit același design, astfel încât ambii ajutoare au lucrat prin aceleași permutări ale indexului de bază. Putem calcula -valoarea din buclă rezultă exact în același mod:
p_iter <- (1 + sum(null_iter >= observed - tol)) /
  (length(null_iter) + 1)

c(values = p_value, iterator = p_iter)
  values iterator
  0.0142   0.0142
Un detaliu de reținut: permutator() generează și stochează matricea de permutare atunci când creați iteratorul. Distribuie rânduri pe rând, dar nu le generează leneș sau înlătură nevoia de a stoca matricea de index.
Reutilizarea unui set
De asemenea, puteți transmite o matrice de index existentă permutator(). Acest lucru este util atunci când doriți ca mai multe calcule să folosească exact aceleași permutări sau doriți să revedeți mai târziu un set salvat:
set.seed(42)
indices <- shuffleSet(nrow(PlantGrowth), control = ctrl)

next_perm <- permutator(perms = indices)
i <- next_perm()
head(PlantGrowth$weight(i))
(1) 6.03 4.50 4.17 5.37 5.14 6.11
Crearea unui alt iterator peste acea matrice începe de la început:
replay <- permutator(perms = indices)
identical(i, replay())
Aprovizionare fie perms sau argumentele generaţiei precum n, nsetși control. Matricea a trecut la perms trebuie să conțină indici de observație, cum ar fi cei returnați de shuffleSet(). Greutățile amestecate din permutations() nu sunt interschimbabile cu acea matrice.
Pentru un singur vector și un calcul scurt, îmi place permutations() cu apply(). Când calculul se potrivește mai natural într-o buclă sau vreau să reutilizam un set salvat de indici, permutator() este la îndemână. Ambele lasă alegerea designului de permutare cu how()astfel încât același flux de lucru se extinde și la modelele restricționate atunci când datele le solicită. Manualul pachetului conține detalii, iar feedbackul este binevenit cu privire la instrumentul de urmărire a problemelor.
