(Acest articol a fost publicat pentru prima dată pe Statforbiologieși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta problema legată de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
În statistică, dependența sau asociere este orice relație statistică, cauzală sau nu, între două variabile aleatoare sau date bivariate. Este adesea măsurată prin coeficientul de corelație al lui Pearson:
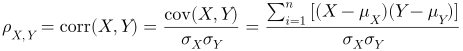
Se pot gândi și alte măsuri de corelare, cum ar fi Spearman 
 coeficientul de corelare a rangului sau Kendall
 coeficientul de corelare a rangului.
Coeficienții de corelație Pearson fac câteva ipoteze, care ar trebui verificate cu atenție.
- Măsurare la nivel de interval: Ambele variabile trebuie măsurate pe o scară cantitativă.
- Eșantionare aleatorie: Fiecare subiect din eșantion ar trebui să contribuie cu o valoare
 și o valoare pe
 . Valorile pentru ambele variabile ar trebui să reprezinte un eșantion aleatoriu extras din populația de interes.
- Linearitate: Relația dintre şi ar trebui să fie liniară.
- Distribuție normală bivariată: Aceasta înseamnă că (i) valorile lui urmeaza o distributie normala la fiecare nivel de și (ii) valorile lui urmeaza o distributie normala la fiecare nivel de .
Este posibil să se testeze dacă  împotriva alternativei $ r $. Testul se bazează pe statistica testului:
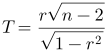 care urmează unui Student
 distributie cu
 grade de libertate.
Să luăm cele două variabile cyl şi mpg din mtcars cadru de date. Pentru aceste variabile, indicele de corelație al lui Pearson este (vă rugăm să rețineți că pentru aceste variabile ar putea fi preferată corelația lui Spearman, deși am neglijat acest lucru de dragul simplității):
r <- cor(mtcars$cyl, mtcars$gear)
r
## (1) -0.4926866
Statistica T este:
T <- r * sqrt(32 - 2) / sqrt(1 - r^2)
T
## (1) -3.101051
Valoarea p pentru ipoteza nulă este:
2 * pt(T, 30)
## (1) 0.004173297
ceea ce este în mod clar foarte semnificativ. Nulul poate fi respins.
La efectuarea acestui test, este important de remarcat faptul că indivizii de la care au fost luate perechile de măsurători trebuie să fie independenți. Dacă nu sunt, „testul t” este invalid. Am discutat despre acest aspect într-o altă postare de pe blogul meu.
Am văzut deja că putem folosi funcția standard cor(matrice, metodă = …). Pentru a obține și niveluri de semnificație, putem folosi rcorr() funcția din pachetul „Hmisc”:
# Correlations with significance levels
library(Hmisc)
corr2 <- rcorr(as.matrix(mtcars), type="pearson")
print(corr2$r, digits = 2)
##        mpg   cyl  disp    hp   drat    wt   qsec    vs     am  gear   carb
## mpg   1.00 -0.85 -0.85 -0.78  0.681 -0.87  0.419  0.66  0.600  0.48 -0.551
## cyl  -0.85  1.00  0.90  0.83 -0.700  0.78 -0.591 -0.81 -0.523 -0.49  0.527
## disp -0.85  0.90  1.00  0.79 -0.710  0.89 -0.434 -0.71 -0.591 -0.56  0.395
## hp   -0.78  0.83  0.79  1.00 -0.449  0.66 -0.708 -0.72 -0.243 -0.13  0.750
## drat  0.68 -0.70 -0.71 -0.45  1.000 -0.71  0.091  0.44  0.713  0.70 -0.091
## wt   -0.87  0.78  0.89  0.66 -0.712  1.00 -0.175 -0.55 -0.692 -0.58  0.428
## qsec  0.42 -0.59 -0.43 -0.71  0.091 -0.17  1.000  0.74 -0.230 -0.21 -0.656
## vs    0.66 -0.81 -0.71 -0.72  0.440 -0.55  0.745  1.00  0.168  0.21 -0.570
## am    0.60 -0.52 -0.59 -0.24  0.713 -0.69 -0.230  0.17  1.000  0.79  0.058
## gear  0.48 -0.49 -0.56 -0.13  0.700 -0.58 -0.213  0.21  0.794  1.00  0.274
## carb -0.55  0.53  0.39  0.75 -0.091  0.43 -0.656 -0.57  0.058  0.27  1.000
print(corr2$P, digits = 2)
##          mpg     cyl    disp      hp    drat      wt    qsec      vs      am
## mpg       NA 6.1e-10 9.4e-10 1.8e-07 1.8e-05 1.3e-10 1.7e-02 3.4e-05 2.9e-04
## cyl  6.1e-10      NA 1.8e-12 3.5e-09 8.2e-06 1.2e-07 3.7e-04 1.8e-08 2.2e-03
## disp 9.4e-10 1.8e-12      NA 7.1e-08 5.3e-06 1.2e-11 1.3e-02 5.2e-06 3.7e-04
## hp   1.8e-07 3.5e-09 7.1e-08      NA 1.0e-02 4.1e-05 5.8e-06 2.9e-06 1.8e-01
## drat 1.8e-05 8.2e-06 5.3e-06 1.0e-02      NA 4.8e-06 6.2e-01 1.2e-02 4.7e-06
## wt   1.3e-10 1.2e-07 1.2e-11 4.1e-05 4.8e-06      NA 3.4e-01 9.8e-04 1.1e-05
## qsec 1.7e-02 3.7e-04 1.3e-02 5.8e-06 6.2e-01 3.4e-01      NA 1.0e-06 2.1e-01
## vs   3.4e-05 1.8e-08 5.2e-06 2.9e-06 1.2e-02 9.8e-04 1.0e-06      NA 3.6e-01
## am   2.9e-04 2.2e-03 3.7e-04 1.8e-01 4.7e-06 1.1e-05 2.1e-01 3.6e-01      NA
## gear 5.4e-03 4.2e-03 9.6e-04 4.9e-01 8.4e-06 4.6e-04 2.4e-01 2.6e-01 5.8e-08
## carb 1.1e-03 1.9e-03 2.5e-02 7.8e-07 6.2e-01 1.5e-02 4.5e-05 6.7e-04 7.5e-01
##         gear    carb
## mpg  5.4e-03 1.1e-03
## cyl  4.2e-03 1.9e-03
## disp 9.6e-04 2.5e-02
## hp   4.9e-01 7.8e-07
## drat 8.4e-06 6.2e-01
## wt   4.6e-04 1.5e-02
## qsec 2.4e-01 4.5e-05
## vs   2.6e-01 6.7e-04
## am   5.8e-08 7.5e-01
## gear      NA 1.3e-01
## carb 1.3e-01      NA
De asemenea, putem folosi aceste funcții cu două matrice separate pentru a obține corelațiile dintre fiecare coloană a unei matrice și fiecare coloană a celeilalte:
# Correlation matrix from mtcars
x <- mtcars(1:3)
y <- mtcars(4:6)
cor(x, y)
##              hp       drat         wt
## mpg  -0.7761684  0.6811719 -0.8676594
## cyl   0.8324475 -0.6999381  0.7824958
## disp  0.7909486 -0.7102139  0.8879799
Coeficientul de corelație și panta în regresia liniară au unele asemănări, deoarece ambele descriu cum schimba cu . Totuși, în corelație, avem de-a face cu două variabile aleatoare, în timp ce în regresia liniară simplă tratăm ca fix şi ca variabilă aleatoare, cu privită ca o funcţie a (si nu invers).
În ciuda interpretărilor lor distincte, este util să se examineze relația algebrică dintre coeficientul de corelație și panta de regresie. Să simulăm un set de date cu două variabile extrase dintr-o distribuție normală multivariată, cu medii de 10 și, respectiv, 2 și o matrice varianță-covarianță de:
library(MASS)
cov <- matrix(c(2.20, 0.48, 0.48, 0.20), 2, 2)
cov
##      (,1) (,2)
## (1,) 2.20 0.48
## (2,) 0.48 0.20
Folosim mvrnomr() funcția de generare a setului de date.
set.seed(1234)
dataset <- data.frame( mvrnorm(n=10, mu = c(10, 2), Sigma = cov) )
names(dataset) <- c("X", "Y")
dataset
##            X        Y
## 1  11.756647 2.547203
## 2   9.522180 2.199740
## 3   8.341254 1.862362
## 4  13.480005 2.772031
## 5   9.428296 1.573435
## 6   9.242788 1.861756
## 7  10.817449 2.343918
## 8  10.749047 2.451999
## 9  10.780400 2.436263
## 10 11.480301 1.590436
Coeficientul de corelație și panta sunt după cum urmează:
r <- with(dataset, cor(X, Y))
b1 <- coef( lm(Y ~ X, data=dataset) )(2)
r
## (1) 0.6372927
b1
##         X
## 0.1785312
Formula pentru panta este:
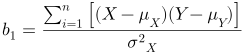
Din aceasta, vedem că:

şi:

Într-adevăr:
sigmaX <- with(dataset, sd(X) )
sigmaY <- with(dataset, sd(Y) )
b1 * sigmaX / sigmaY
##         X
## 0.6372927
r * sigmaY / sigmaX
## (1) 0.1785312
De asemenea, este ușor de observat că coeficientul de corelație este echivalent cu panta de regresie a standardizat împotriva standardizate :
Yst <- with(dataset, scale(Y, scale=T) )
summary( lm(Yst ~ I(scale(X, scale = T) ), data = dataset) )
##
## Call:
## lm(formula = Yst ~ I(scale(X, scale = T)), data = dataset)
##
## Residuals:
##       Min        1Q    Median        3Q       Max
## -0.082006 -0.067143 -0.036850  0.009214  0.237923
##
## Coefficients:
##                         Estimate Std. Error t value Pr(>|t|)
## (Intercept)            1.065e-18  3.478e-02   0.000   1.0000
## I(scale(X, scale = T)) 1.785e-01  7.633e-02   2.339   0.0475 *
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 0.11 on 8 degrees of freedom
## Multiple R-squared:  0.4061, Adjusted R-squared:  0.3319
## F-statistic: 5.471 on 1 and 8 DF,  p-value: 0.04748
Acesta este un concept înrudit, dar distinct. În timp ce coeficientul de corelație al lui Pearson este utilizat pentru datele bivariate – unde sunt observate două variabile diferite pe aceleași unități independente – corelația intraclasă apare atunci când aceeași variabilă este observată în mod repetat pe aceleași unități (de exemplu, în timp sau spații diferite), astfel încât fiecare unitate acționează ca un factor de grupare care creează grupuri de măsurători.
Să ilustrăm acest lucru cu un exemplu. Luați în considerare următorul tabel de date:
#|echo: false
m1 <- c(10, 12, 13, 16)
m2 <- c(21, 20, 17, 19)
dtab <- cbind(m1, m2)
row.names(dtab) <- paste0("g", 1:4)
knitr::kable(dtab)
| g1 | 10 | 21 |
| g2 | 12 | 20 |
| g3 | 13 | 17 |
| g4 | 16 | 19 |
Când g1, g2, g3 și g4 reprezintă patru unități independente (de exemplu, patru plante de porumb) pe care au fost măsurate două variabile, m1 și m2 (de exemplu, greutatea și înălțimea), ne aflăm în domeniul corelației lui Pearson. Pe de altă parte, când g1, g2, g3 și g4 sunt entități pe care sunt luate mai multe măsurători ale aceleiași variabile (de exemplu, randament), intrăm în domeniul corelației intraclasă. În acest al doilea scenariu, nu evaluăm variabilitatea comună între două variabile diferite; mai degrabă, dorim să determinăm dacă aparținând aceluiași grup („proximitatea”) face observațiile mai asemănătoare între ele decât observațiile din grupuri diferite.
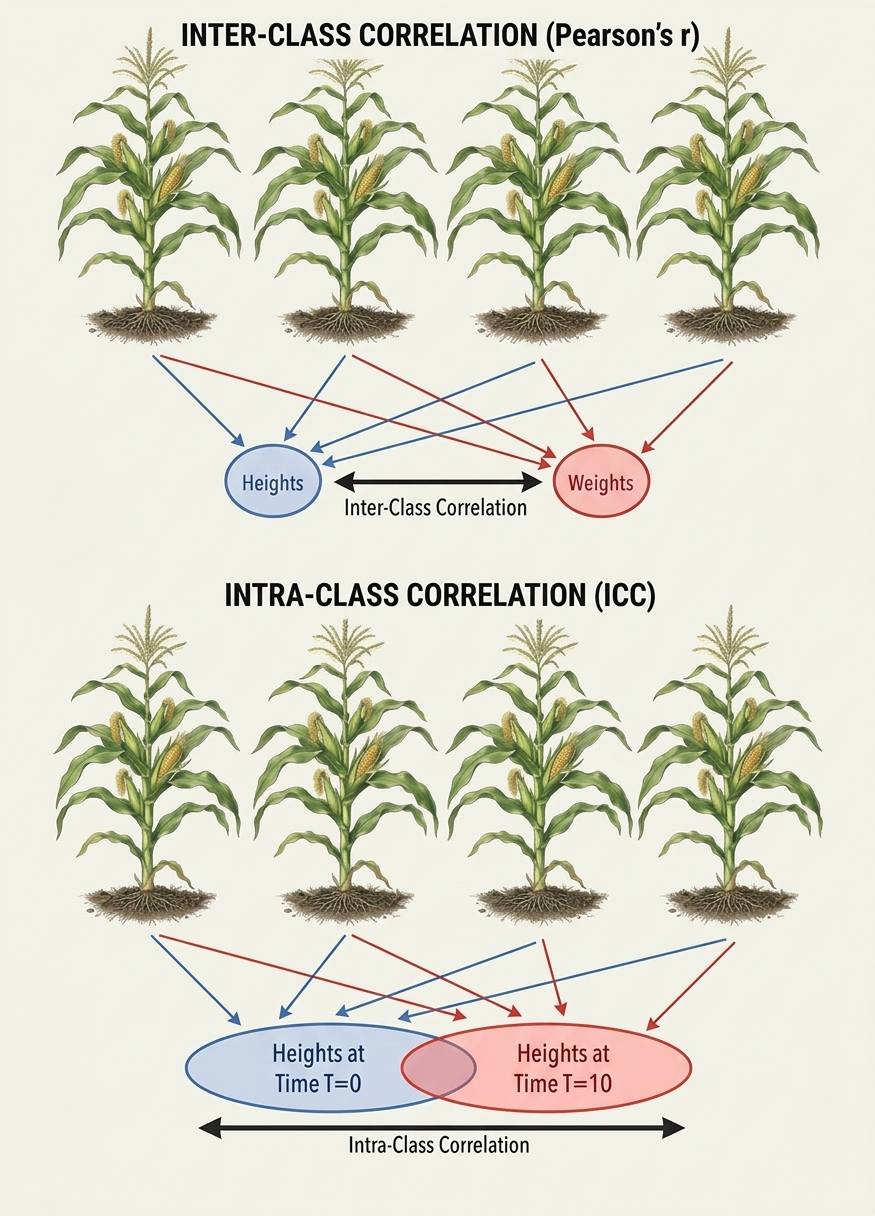
Figura 1: Confronto concettuale tra Pearson e ICC
Cel mai comun coeficient de corelație intraclasă este:
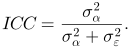
unde  este componenta varianței între grupuri și
 este componenta variației în cadrul unui grup (sau, mai clar, varianța observațiilor în cadrul unui grup). Pentru date echilibrate, acele două componente pot fi obținute din ANOVA unidirecțională, având în vedere că există patru „replicate” per grup:
y <- c(10, 12, 13, 16, 21, 20, 17, 19)
group <- factor( rep(c("A", "B"), each = 4) )
nmeasures <- 4
mod <- lm(y ~ group)
anova(mod)
## Analysis of Variance Table
##
## Response: y
##           Df Sum Sq Mean Sq F value   Pr(>F)
## group      1   84.5  84.500  18.436 0.005128 **
## Residuals  6   27.5   4.583
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
sigma2_alpha <- (84.5 - 4.583)/nmeasures
sigma2_epsilon <- 4.583
icc <- sigma2_alpha/(sigma2_alpha + sigma2_epsilon)
icc
## (1) 0.8134129
În general, dacă subiecții dintr-un grup sunt foarte asemănători (mici  ), în timp ce diferitele grupuri variază foarte mult (înalt
 ), ICC este ridicat. În schimb, dacă măsurătorile sunt la fel de similare între grupuri diferite precum sunt în cadrul aceluiași grup, ICC este scăzut. În teorie, ICC nu poate fi negativ, deoarece componentele varianței sunt de așteptat să fie pozitive. În practică, totuși, ICC calculat prin metoda momentelor prezentată mai sus poate deveni negativ atunci când pătratul mediu al grupului este mai mic decât pătratul mediu rezidual din ANOVA. Astfel de valori negative sunt de obicei limitate la zero sau interpretate ca indicând o absență a grupării pozitive; în ambele cazuri, corelația intraclasă rămâne un instrument semnificativ.
ICC este crucial și este cel mai adesea studiat folosind modele mixte liniare. Dar… asta este o poveste pentru o altă zi…
Mulțumim pentru lectură și codificare fericită!
(PS Dacă v-a plăcut această postare, consultați cartea mea „Metode de cercetare pe teren în agricultură: o introducere cu R” prin linkul de mai jos!)
prof. Andrea Onofri
Departamentul de Științe Agricole, Alimentației și Mediului
Universitatea din Perugia (Italia)
Trimite comentarii la: (e-mail protejat)
Această postare a fost publicată inițial pe 2019-02-07
