(Acest articol a fost publicat pentru prima dată pe Patrice Godardși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta problema legată de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
Documentarea a fost întotdeauna scopul
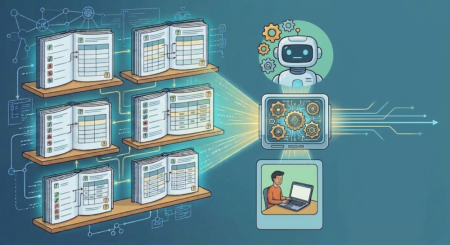
TKCat (Tailored Knowledge Catalog) este construit pe o idee simplă: o resursă de cunoștințe este mai mult decât un set de tabele. În TKCat, fiecare resursă este a baza de date modelată (MDB) care conține:
- o descriere generală a resursei (sursa, versiunea, domeniul de aplicare),
- o model de date realizat cu ReDaMoR, cu un comentariu pe fiecare tabel și câmp, plus chei primare, chei externe și indecși,
- membrii colectieicare spun ce domenii se referă la același tip de concept (gene, boli, țesuturi…) și fac posibilă integrarea diferitelor MDB.
Această documentație a fost concepută de la început pentru a fi pregătită pentru mașină și se dovedește a fi exact ceea ce are nevoie un model de limbaj mare (LLM) pentru a funcționa corect cu datele.
Ce este MCP
Modelul Context Protocol (MCP), introdus de Anthropic, este un standard deschis care permite asistenților AI să se conecteze în siguranță la surse de date externe, instrumente și fluxuri de lucru. Gândiți-vă la el ca la un adaptor universal pentru AI: în loc să scrieți integrări personalizate pentru fiecare combinație de LLM și bază de date, MCP oferă o arhitectură standardizată client-server.
În această configurare, un client MCP (cum ar fi Claude Desktop, Claude Code sau Posit Assistant) comunică cu un server MCP folosind un protocol comun prin conexiuni locale sau la distanță. Serverul expune un set definit de „instrumente” și resurse pe care asistentul le poate descoperi și invoca în mod dinamic, pe baza solicitării limbajului natural al utilizatorului.
Pentru TKCat, MCP este o potrivire naturală. În loc să forțeze dezvoltatorii să construiască interfețe de chat personalizate sau să scrie prompturi personalizate fragile pentru fiecare catalog, TKCat 1.3.0 își expune bazele de date modelate direct printr-un server MCP standard. Orice asistent compatibil MCP dobândește instantaneu vocabularul structurat, hărțile relațiilor și balustradele de securitate de care are nevoie pentru a naviga, a interoga și a sintetiza resursele de cunoștințe în siguranță.
Ce este nou în TKCat 1.3.0
TKCat 1.3.0 include un server MCP numai pentru citire. Cu acesta, asistenții AI precum Claude Code, Claude Desktop, Posit Assistant sau orice alt client MCP pot explora și interoga MDB-urile unei instanțe chTKCat (TKCat pe ClickHouse).
Serverul vine sub două forme:
chTKCat_mcp_server(): a local server, pornit de clientul MCP pe computerul utilizatorului (transport stdio).chTKCat_mcp_http_server(): a telecomanda server care rulează ca un serviciu lângă instanța chTKCat (transport HTTP în flux). Utilizatorii nu au nevoie de R sau TKCat pe computerul lor.
Asistentul are un set mic de instrumente care se potrivesc modului în care lucrează un analist atent cu o resursă necunoscută:
| Găsiți resurse relevante | list_mdbs, search_tkcat |
| Înțelege-i | describe_mdb, describe_tables, list_collections |
| Uită-te la date | preview_table |
| Răspunde la întrebare | query_mdb (ClickHouse SQL), get_matrix_values |
De ce bazele de date documentate fac diferența
Puneți unui LLM o întrebare despre o bază de date pe care nu a văzut-o niciodată și acesta va ghici: poate deduce semnificațiile tabelelor din numele lor, poate presupune îmbinări și poate greși semantica unei coloane. Cu TKCat, asistentul nu trebuie să ghicească:
- Găsește resursa potrivită. Descrierile MDB și căutarea de cuvinte cheie prin comentarii de tabel și câmp le indică resursele care contează, chiar și într-un catalog de zeci de baze de date.
- Înțelege datele. Comentariile câmpului explică codurile, unitățile și convențiile. Cheile externe arată cum pot fi alăturate tabelele. Deci SQL-ul pe care îl scrie urmează modelul de date real.
- Acesta integrează resurse. Colecțiile spun când, de exemplu, un identificator de genă dintr-un MDB poate fi comparat cu un identificator de genă din altul și în ce condiții (aceeași sursă, același organism). Asistentul poate apoi să răspundă la întrebări care acoperă mai multe resurse într-o singură interogare.
- Răspunsurile sale pot fi verificate. Fiecare răspuns este construit din interogări SQL explicite pe resurse și versiuni identificate. Puteți să le citiți, să le rulați din nou în R și să le refolosiți.
Un schimb tipic arată astfel:
Utilizator: Ce medicamente vizează genele asociate cu fenotipurile acestei boli?
Asistent: caută în catalog → citește descrierile MDB-urilor fenotip, variante și medicamente → verifică colecțiile care le leagă → previzualizează câteva înregistrări → rulează o interogare SQL cross-MDB → returnează răspunsul, cu interogările pe care le-a executat și resursele pe care le-a folosit.
Cu cât documentația este mai bună, cu atât răspunsurile sunt mai bune. Efortul depus pentru a documenta o resursă acum dă roade de fiecare dată când cineva pune o întrebare despre aceasta, într-un limbaj simplu.
Creat pentru medii partajate, guvernate
Resursele de cunoștințe au adesea reguli de acces diferite și sunt găzduite de o organizație mai degrabă decât pe un laptop personal. Serverul MCP a fost proiectat având în vedere acest lucru:
- Numai citire prin design: asistentul poate interoga date, dar nu poate scrie, crea, șterge sau modifica granturi.
- Acces per utilizator: cu serverul de la distanță, utilizatorii se conectează cu propriile acreditări chTKCat, pe care ClickHouse le verifică. Fiecare utilizator vede doar MDB-urile pe care le este permis să le citească.
- Ieșire controlată: limitele pentru rândurile returnate, dimensiunea ieșirii și timpul de execuție a interogărilor mențin apelurile la instrumente mici și rapide.
- Implementare scalabilă: serverul la distanță este apatrid, astfel încât mai multe instanțe pot rula în spatele unui proxy invers, cum ar fi nginx, iar apelurile de instrumente sunt înregistrate.


Ca și în cazul oricărui serviciu AI, expuneți numai MDB-urile al căror conținut poate fi partajat cu asistentul conform politicilor organizației dvs.
Noțiuni de bază
Cel mai bun loc pentru a începe este noul Vigneta TKCat end-to-end. Acesta acoperă întregul proces:
- configurarea unei instanțe ClickHouse pentru TKCat,
- pregătirea exemplelor de MDB (HPO, ClinVar, ChEMBL),
- împingându-le la ClickHouse și interogându-le din R,
- implementarea serverului MCP (local și la distanță, cu systemd și nginx),
- configurarea clienților MCP (Claude Code, Claude Desktop, Posit Assistant).
Pentru detalii de referință despre server, instrumentele și parametrii acestuia, consultați vigneta serverului MCP.
Pentru o introducere completă în TKCat, consultați vigneta principală.
