Am dat permuta putina atentie recent. Două completări ar trebui să faciliteze configurarea testelor de permutare: o opțiune pentru set de partiții ordonateși formule pentru specificarea parcelelor și blocurilor. Acesta este un nume destul de mare pentru prima adăugare, așa că să începem cu ceea ce face.
Aceste modificări sunt în versiunea de dezvoltare. Pentru a urma, instalează-l din universul meu R:
install.packages("permute", repos = c(
  "https://gavinsimpson.r-universe.dev",
  "https://cloud.r-project.org"
))
Aceleași grupuri, mai puține permutări
The jackal datele care vin cu permuta conțin lungimi de mandibule, în milimetri, pentru șacali de aur de sex masculin și feminin. Sunt folosite și în vigneta pachetului. Să ne întrebăm dacă lungimea medie a mandibulei diferă între sexe.
library("permute")
data(jackal, package = "permute")

table(jackal$Sex)
Am putea amesteca toți indicii de observație și să-i folosim pentru a rearanja etichetele sexului. Cu implicit Within(type = "free") design, numărul de permutări posibile ale indexului este:
numPerms(nrow(jackal), control = how(within = Within(type = "free")))
Dar schimbarea unei perechi de masculi sau a unei perechi de femele lasă etichetele grupului neschimbate. Dacă statistica noastră este o diferență de mijloace, nu am creat un rezultat diferit făcând asta.
Ceea ce avem nevoie sunt modalitățile distincte de atribuire a observațiilor la două grupuri etichetate, păstrând dimensiunile grupurilor fixe. Aceasta este partiția setată ordonată. Aici, ordonat înseamnă că grupurile se pot distinge – bărbații și femeile au roluri diferite – mai degrabă decât că observațiile trebuie sortate în interiorul fiecărui grup.
Noua opțiune este type = "partition" care aparține în Plots(). Voi folosi și noua interfață de formulă aici; ~ Sex spune pentru a obține variabila de grupare de la datala care trecem jackal:
ctrl <- how(
  plots = Plots(strata = ~ Sex, type = "partition"),
  data = jackal
)

numPerms(nrow(jackal), control = ctrl)
Aceasta este o reducere destul de mare față de toate permutările posibile ale indicilor de observație! În general, dacă mărimile grupului sunt  numărul de misiuni distincte este


Mărimile grupurilor provin din date; nu trebuie să fie egali.
Încă primim indici de observație înapoi de la permutaastfel încât fluxul de lucru obișnuit de indexare funcționează:
set.seed(42)
p <- shuffle(nrow(jackal), control = ctrl)

table(jackal$Sex(p))
Etichetele au fost amestecate, dar numărul lor nu s-a schimbat. În cadrul vectorului index returnat, observațiile care au avut inițial aceeași etichetă își păstrează ordinea relativă. Acest lucru ne oferă câte un reprezentant pentru fiecare aranjament distinct al etichetelor, în loc de toate permutările de index care l-ar produce.
Există o diferență importantă față de Plots(type = "free"): acea opțiune mută parcele întregi ca unități intacte. Opțiunea de partiție rearanjează apartenența la grup. how() selectează de asemenea Within(type = "none") automat pentru proiectarea unei partiții. Solicitarea de amestecare și în cadrul acestor grupuri ar anula comenzile redundante pe care încercăm să le omitem, astfel încât alte tipuri în interiorul complotului nu sunt permise.
Un test de permutare cu lm()
permuta nu este doar pentru utilizare cu vegan pachet — a fost conceput pentru a fi agnostic față de modelul de bază sau statistica de testare. Ca o ilustrare, să potrivim un model liniar la datele șacalului:
fit <- lm(Length ~ Sex, data = jackal)
coef(fit)
(Intercept)   SexFemale
      113.4        -4.8
Interceptarea este media pentru bărbați, nivelul de referință. Al doilea coeficient este media feminină minus media masculină: femelele au mandibule care sunt, în medie, cu 4,8 mm mai scurte în aceste date.
Pentru un test de permutare, vom păstra lungimile acolo unde sunt și vom amesteca etichetele sexului. Apoi reajustăm modelul pentru fiecare sarcină și salvăm același coeficient. Conform ipotezei nule, tratăm etichetele ca fiind schimbabile între observații; aceasta trebuie să fie o presupunere rezonabilă pentru datele pe care le analizăm.
set.seed(42)
perms <- shuffleSet(nrow(jackal), nset = 999, control = ctrl)

observed <- unname(coef(fit)(2))
null <- apply(perms, 1, function(i) {
  permuted <- jackal
  permuted$Sex <- jackal$Sex(i)
  unname(coef(lm(Length ~ Sex, data = permuted))(2))
})
shuffleSet() ne oferă o matrice cu o atribuire pe rând. Eșantionăm aici un set ușor de gestionat, în loc să adaptăm un model pentru fiecare sarcină posibilă.
Iată cum arată acești coeficienți, cu diferența observată marcată cu roșu:
hist(null, breaks = "FD", main = "",
     xlab = "Female minus male mean mandible length (mm)",
     col = "grey85", border = "white")
abline(v = observed, col = "firebrick", lwd = 2)
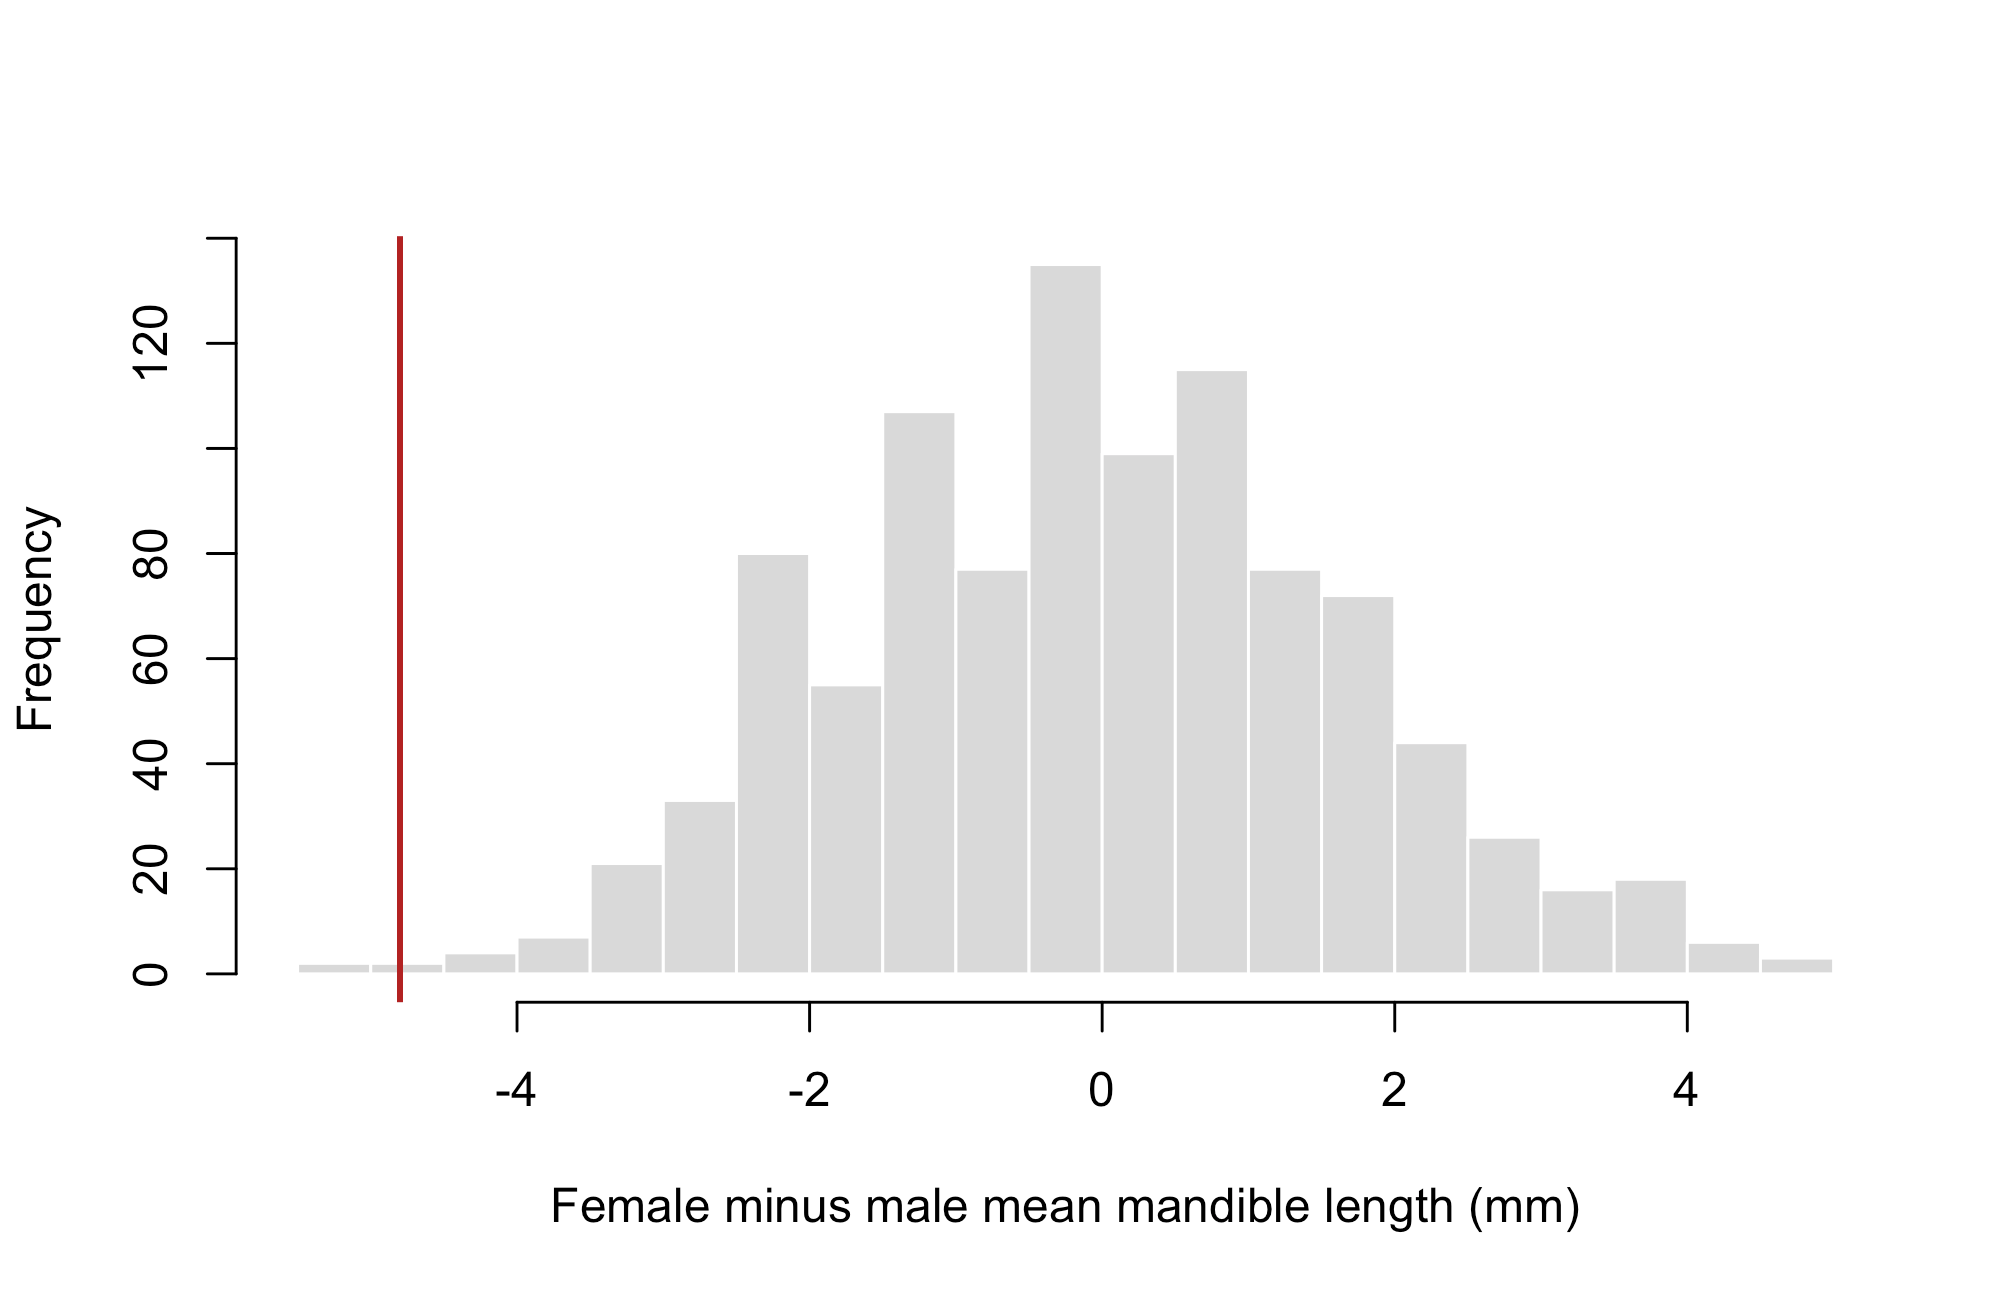
Pentru un test cu două fețe, numărăm diferențele cel puțin la fel de mari ca și cea observată în valoare absolută:
tol <- sqrt(.Machine$double.eps)
p_value <- (1 + sum(abs(null) >= abs(observed) - tol)) /
  (nrow(perms) + 1)

c(difference_mm = observed, p_value = p_value)
difference_mm       p_value
       -4.800         0.005
Toleranța mică include legături care altfel ar putea fi omise din cauza aritmeticii în virgulă mobilă în potrivirile modelului. Adăugarea unui număr la numărător și numitor include rezultatul observat în acest test Monte Carlo. Valoarea p este o estimare bazată pe alocările eșantionate, deci va varia în funcție de sămânța aleatoare și de numărul solicitat.
Dacă nu aveți nevoie să construiți un design în mod explicit, shufflePartition(jackal$Sex) şi shufflePartitionSet(jackal$Sex, nset = 999) sunt scurtături utile. Există, de asemenea allPartitions() pentru enumerarea completă atunci când spațiul de atribuire este suficient de mic. Ca și cu allPerms()omite atribuirea observată în mod implicit; utilizare control = how(observed = TRUE) să-l includă.
Mai puține tastări cu formule
Interfața cu formulă funcționează atât pentru straturile de parcelă, cât și pentru blocuri. Pentru a le arăta pe cei doi împreună, să folosim datele de pe luncă de dune de la vegan. dune conţine datele despre specii şi dune.env conţine variabilele de mediu corespunzătoare.
Să presupunem că vrem să ne uităm la asocierea dintre vegetație și grosimea orizontului A1 a solului, permițând comparații doar între situri cu același management și utilizare a terenului. Putem exprima acea restricție direct:
library("vegan")
data(dune, package = "vegan")
data(dune.env, package = "vegan")

formula_ctrl <- how(
  plots = Plots(strata = ~ Management / Use),
  blocks = ~ Management,
  data = dune.env
)
~ Management / Use creează un factor de grupare pentru combinațiile observate de management și utilizare a terenului. Plots() implicit la type = "none"în timp ce Within() implicit la "free"astfel încât site-urile sunt amestecate în aceste combinații. Blocurile spun că site-urile trebuie să rămână și în categoria lor de management. Restricția intrigii implică deja acest lucru aici, dar scrierea ambelor face ierarhia clară.
Aceste restricții presupun site-urile pot fi schimbate în cadrul fiecărei combinații management-utilizare; gruparea acestora în acest fel nu ține cont de nicio dependență spațială rămasă.
Putem verifica unde o amestecare reală trimite observațiile:
set.seed(42)
i <- shuffle(nrow(dune.env), control = formula_ctrl)

all(getBlocks(formula_ctrl)(i) == getBlocks(formula_ctrl))
all(getStrata(formula_ctrl)(i) == getStrata(formula_ctrl))
Sunt respectate atât blocurile, cât și grupele de parcele. Putem folosi designul direct într-un vegan analiză. Aici elimin parțial grupurile de management-utilizare într-un RDA, apoi testez asocierea suplimentară cu grosimea orizontului A1:
env <- dune.env
env$group <- getStrata(formula_ctrl)
ord <- rda(dune ~ A1 + Condition(group), data = env)

set.seed(42)
anova(ord, permutations = formula_ctrl)
Permutation test for rda under reduced model
Blocks:  Management
Plots: Management/Use, plot permutation: none
Permutation: free
Number of permutations: 199

Model: rda(formula = dune ~ A1 + Condition(group), data = env)
         Df Variance      F Pr(>F)
Model     1   4.3492 1.3265  0.225
Residual  8  26.2298
Există puține dovezi ale unei asocieri suplimentare în această analiză specială. Unele dintre grupuri conțin un singur site, astfel încât site-urile respective nu se pot muta deloc sub acest design. Restricțiile contează, atât pentru întrebarea pe care o punem, cât și pentru câte informații sunt disponibile pentru a răspunde.
Câteva detalii merită să aveți în vedere atunci când scrieți aceste formule. Ele descriu factori de grupare, nu termeni model: ~ Management + Use, ~ Management:Useși ~ Management / Use toate produc grupuri din combinațiile acelor variabile. Bara oblică nu creează un nivel suplimentar în permutaierarhia lui.
De asemenea, când Plots() este înăuntru how()aprovizionare data la how()ca mai sus. Dacă construiești Plots() pe cont propriu, poate lua propriul argument de date:
plot_groups <- Plots(strata = ~ Management / Use, data = dune.env)
Interfața factor existent încă funcționează, așa că nu este nevoie să rescrieți codul vechi. Dar mi se pare că formulele sunt mai ușor de citit, mai ales atunci când variabilele de grupare trebuie combinate. Puteți găsi detalii în documentația de proiectare și aș dori feedback cu privire la fiecare adăugare prin intermediul instrumentului de urmărire a problemelor.
Există, de asemenea, noi ajutoare pentru a lucra cu permutările rezultate: permutations() returnează valorile amestecate direct, while permutator() vă permite să treceți printr-un set de permutări. Le voi arăta într-o postare ulterioară.
