(Acest articol a fost publicat pentru prima dată pe Statforbiologieși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta problema legată de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
Când avem un tabel de date cu mai multe trăsături, ne-ar putea interesa să investigăm structura variabilității și relațiile reciproce (cazale sau non-cauzale) dintre variabile. De exemplu, să luăm în considerare setul de date „mtcars”, prezentat mai jos:
data(mtcars)
head(mtcars)
##                    mpg cyl disp  hp drat    wt  qsec vs am gear carb
## Mazda RX4         21.0   6  160 110 3.90 2.620 16.46  0  1    4    4
## Mazda RX4 Wag     21.0   6  160 110 3.90 2.875 17.02  0  1    4    4
## Datsun 710        22.8   4  108  93 3.85 2.320 18.61  1  1    4    1
## Hornet 4 Drive    21.4   6  258 110 3.08 3.215 19.44  1  0    3    1
## Hornet Sportabout 18.7   8  360 175 3.15 3.440 17.02  0  0    3    2
## Valiant           18.1   6  225 105 2.76 3.460 20.22  1  0    3    1
Având în vedere diferitele mașini (de-a lungul rândurilor), ne-ar putea interesa să investigăm structura variabilității consumului de combustibil (mpg), număr de cilindri (cil), cilindree (disp) și cai putere (CP). Cât de mult se schimbă fiecare variabilă între diferitele mașini? Cât de mult se schimbă fiecare variabilă atunci când se modifică o altă variabilă? Există vreun fel de variație comună, fie pozitivă, fie negativă?
O statistică potrivită pentru a răspunde la aceste întrebări este covarianța, adică:
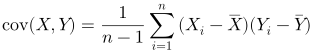
unde 
 şi
 sunt mijloacele pentru fiecare variabilă și
 este numărul de indivizi. În cuvinte, covarianța este suma produselor lui ith abateri de la medie pentru ambele variabile. În această setare, varianța este doar covarianța unei variabile cu ea însăși.
Pentru un tabel de date, varianțele și covarianțele pot fi calculate utilizând cov() funcție, care returnează o matrice (matricea varianță-covarianță, într-adevăr):
matr <- mtcars(,1:4)

# Covariances
Sigma <- cov(matr)
Sigma
##              mpg        cyl       disp        hp
## mpg    36.324103  -9.172379  -633.0972 -320.7321
## cyl    -9.172379   3.189516   199.6603  101.9315
## disp -633.097208 199.660282 15360.7998 6721.1587
## hp   -320.732056 101.931452  6721.1587 4700.8669
În timp ce covarianțele indică direcția (asociere pozitivă sau negativă), valorile lor depind de scara de măsurare, ceea ce face dificilă măsurarea puterii relației dintr-o privire. Din acest motiv, covarianțele sunt de obicei „standardizate” prin împărțirea la produsul abaterilor standard pentru a obține coeficientul de corelație al lui Pearson:
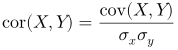
unde  şi
 sunt abaterile standard pentru
 şi
 . Spre deosebire de covarianțe, corelațiile merg de la -1 la 1 și matricea de corelație are 1 de-a lungul diagonalei sale principale (deoarece corelația oricărei variabile cu ea însăși este 1). În R, matricea de corelație este obținută utilizând
cor() funcţie:
# Correlations
R <- cor(matr)
R
##             mpg        cyl       disp         hp
## mpg   1.0000000 -0.8521620 -0.8475514 -0.7761684
## cyl  -0.8521620  1.0000000  0.9020329  0.8324475
## disp -0.8475514  0.9020329  1.0000000  0.7909486
## hp   -0.7761684  0.8324475  0.7909486  1.0000000
Acest lucru ne aduce la întrebarea principală a acestui post: Având în vedere o matrice varianță-covarianță, putem calcula matricea de corelație? Și putem face invers – trecerea de la o matrice de corelație înapoi la o matrice de varianță-covarianță? Cu referire la matricele de mai sus, putem trece de la „Sigma” la „R” și de la „R” la „Sigma”? De multe ori am nevoie să fac aceste conversii, mai ales atunci când lucrez cu modele mixte sau cu analize de serii cronologice.
Având în vedere expresia anterioară, este ușor de observat că, dacă luăm covarianța dintre „disp” și „mpg” de mai sus (-633,0972), corelația poate fi obținută ca:
-633.097208 / (sqrt(36.324103) * sqrt(15360.7998))
## (1) -0.8475514
iar toate informațiile necesare sunt conținute în matricea varianță-covarianță.
Desigur, efectuarea acestor calcule pentru toate covarianțele una câte una este plictisitoare. Întrebarea este: există vreo modalitate simplă de a trece de la o matrice de covarianță la o matrice de corelație cu o singură operație?
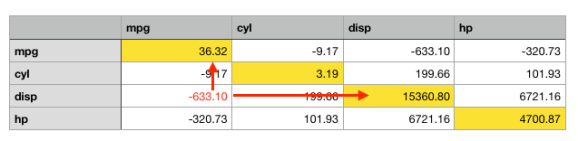
Răspunsul se găsește în algebra matriceală; să aruncăm o privire la matricea varianță-covariană: ceea ce trebuie să facem este să luăm fiecare element din această matrice și să-l împărțim la rădăcinile pătrate ale elementelor diagonale din aceeași coloană și din același rând (vezi figura de mai jos). În consecință, sarcina noastră este:
- luați elementele diagonale
- ia fiecare ith rând și împărțiți toate elementele sale la ith element diagonal (scalarea rândurilor)
- ia fiecare ith coloana matricei rezultate și împărțiți toate elementele acesteia la ith element diagonal (scalarea coloanelor)
Scalare de rânduri poate fi efectuată utilizând algebră-matrice; în special, putem lua o matrice diagonală de greutăți și o înmulțim cu matricea pătrată pe care dorim să o scalam, așa cum se arată mai jos.
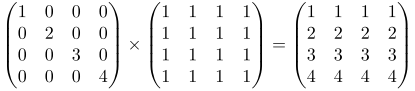
Vedem că toate elementele primului rând au fost înmulțite cu primul element de ponderare, toate elementele din al doilea rând au fost înmulțite cu al doilea element de ponderare și așa mai departe.
Scalarea coloanelor se face în mod similar, dar în ordine inversă: luăm matricea țintă și o post-multiplim cu matricea diagonală a greutăților, așa cum se arată mai jos.
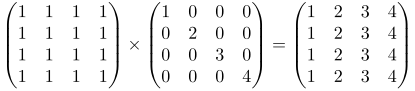
Vedem că toate elementele primei coloane au fost înmulțite cu primul element de ponderare, toate elementele din al doilea rând au fost înmulțite cu al doilea element de ponderare și așa mai departe.
În consecință, putem lua matricea noastră varianță-covarianță și:
- Luați rădăcinile pătrate ale elementelor diagonale (abateri standard) și încărcați-le într-o matrice diagonală
- Inversați această matrice diagonală
- Pre-multiplicați și post-multiplicați matricea varianță-covarianță cu această matrice diagonală a abaterilor standard inversate
# from covariance to correlation - 1
StDev <- sqrt(diag(Sigma))
StDevMat <- diag(StDev)
InvStDev <- solve(StDevMat)
InvStDev %*% Sigma %*% InvStDev
##            (,1)       (,2)       (,3)       (,4)
## (1,)  1.0000000 -0.8521620 -0.8475514 -0.7761684
## (2,) -0.8521620  1.0000000  0.9020329  0.8324475
## (3,) -0.8475514  0.9020329  1.0000000  0.7909486
## (4,) -0.7761684  0.8324475  0.7909486  1.0000000
Soluția anterioară este corectă, dar, în R, este destul de ineficientă. Cel mai bun mod este de a folosi cov2cor() funcția din pachetul „stat”.
# From covariance to correlation - 2
cov2cor(Sigma)
##             mpg        cyl       disp         hp
## mpg   1.0000000 -0.8521620 -0.8475514 -0.7761684
## cyl  -0.8521620  1.0000000  0.9020329  0.8324475
## disp -0.8475514  0.9020329  1.0000000  0.7909486
## hp   -0.7761684  0.8324475  0.7909486  1.0000000
Cu baza R, putem, de asemenea sweep() de două ori:
# From covariance to correlation - 3
sweep(sweep(Sigma, 1, StDev, FUN = "/"), 2, StDev, FUN = "/")
##             mpg        cyl       disp         hp
## mpg   1.0000000 -0.8521620 -0.8475514 -0.7761684
## cyl  -0.8521620  1.0000000  0.9020329  0.8324475
## disp -0.8475514  0.9020329  1.0000000  0.7909486
## hp   -0.7761684  0.8324475  0.7909486  1.0000000
Alternativ, putem combina scale() şi t() (transpune) de două ori, deși este vizibil mai puțin intuitiv:
# From covariance to correlation - 4
scale(t(scale(t(Sigma), center = F, scale = StDev)),
      center = F, scale = StDev)
##             mpg        cyl       disp         hp
## mpg   1.0000000 -0.8521620 -0.8475514 -0.7761684
## cyl  -0.8521620  1.0000000  0.9020329  0.8324475
## disp -0.8475514  0.9020329  1.0000000  0.7909486
## hp   -0.7761684  0.8324475  0.7909486  1.0000000
## attr(,"scaled:scale")
##        mpg        cyl       disp         hp
##   6.026948   1.785922 123.938694  68.562868
O altă abordare foarte curată în R se bazează pe produsul exterior. Dacă avem vectori de abateri standard ($), produsul exterior este:
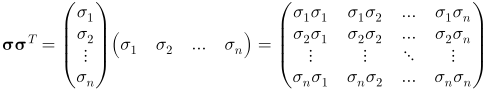
Astfel, corelația se calculează astfel:
# From covariance to correlation - 5
Sigma/outer(StDev, StDev)
##             mpg        cyl       disp         hp
## mpg   1.0000000 -0.8521620 -0.8475514 -0.7761684
## cyl  -0.8521620  1.0000000  0.9020329  0.8324475
## disp -0.8475514  0.9020329  1.0000000  0.7909486
## hp   -0.7761684  0.8324475  0.7909486  1.0000000
Este ușor de observat că:
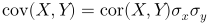 Astfel, dacă avem corelația dintre „disp” și „mpg” (-0,8521620), putem calcula cu ușurință covarianța ca:
-0.8475514 * sqrt(36.324103) * sqrt(15360.7998)
## (1) -633.0972
Singura problemă este că varianțele nu sunt conținute într-o matrice de corelație, așa că trebuie să le obținem din altă parte. Odată ce le avem, noi
-
- Luați-le rădăcinile pătrate și plasați-le într-o matrice diagonală
- Pre-multiplicați și post-multiplicați matricea de corelație pentru această matrice diagonală a abaterilor standard
Soluția este următoarea:
# from correlation to covariance - 1
StDev <- sqrt(diag(Sigma))
StDevMat <- diag(StDev)
StDevMat %*% R %*% StDevMat
##             (,1)       (,2)       (,3)      (,4)
## (1,)   36.324103  -9.172379  -633.0972 -320.7321
## (2,)   -9.172379   3.189516   199.6603  101.9315
## (3,) -633.097208 199.660282 15360.7998 6721.1587
## (4,) -320.732056 101.931452  6721.1587 4700.8669
Mai eficient, putem folosi cor2cov() funcția în pachetul „lavaan”.
# From correlation to covariance - 2
lavaan::cor2cov(R, StDev)
##              mpg        cyl       disp        hp
## mpg    36.324103  -9.172379  -633.0972 -320.7321
## cyl    -9.172379   3.189516   199.6603  101.9315
## disp -633.097208 199.660282 15360.7998 6721.1587
## hp   -320.732056 101.931452  6721.1587 4700.8669
Sau putem sweep() de două ori:
# From correlation to covariance - 3
sweep(sweep(R, 1, StDev, FUN = "*"), 2, StDev, FUN = "*")
##              mpg        cyl       disp        hp
## mpg    36.324103  -9.172379  -633.0972 -320.7321
## cyl    -9.172379   3.189516   199.6603  101.9315
## disp -633.097208 199.660282 15360.7998 6721.1587
## hp   -320.732056 101.931452  6721.1587 4700.8669
sau scale() şi t() de două ori:
# From correlation to covariance - 5
scale(t(scale(t(R), center = F, scale = 1/StDev)),
      center = F, scale = 1/StDev)
##              mpg        cyl       disp        hp
## mpg    36.324103  -9.172379  -633.0972 -320.7321
## cyl    -9.172379   3.189516   199.6603  101.9315
## disp -633.097208 199.660282 15360.7998 6721.1587
## hp   -320.732056 101.931452  6721.1587 4700.8669
## attr(,"scaled:scale")
##         mpg         cyl        disp          hp
## 0.165921457 0.559934979 0.008068505 0.014585154
În cele din urmă, putem folosi produsul exterior după cum urmează:
# From correlation to covariance - 6
R * outer(StDev, StDev)
##              mpg        cyl       disp        hp
## mpg    36.324103  -9.172379  -633.0972 -320.7321
## cyl    -9.172379   3.189516   199.6603  101.9315
## disp -633.097208 199.660282 15360.7998 6721.1587
## hp   -320.732056 101.931452  6721.1587 4700.8669
Aveți un truc mai curat sau mai rapid pentru asta în R? Lasă un comentariu mai jos și voi fi bucuros să-l prezint aici!
Mulțumim pentru lectură și codificare fericită!
(PS Dacă v-a plăcut această postare, consultați cartea mea „Metode de cercetare pe teren în agricultură: o introducere cu R” prin linkul de mai jos!)
prof. Andrea Onofri
Departamentul de Științe Agricole, Alimentației și Mediului
Universitatea din Perugia (Italia)
Trimite comentarii la: (e-mail protejat)