Blogul lui Zhenguo Zhang https://fortune9.netlify.app/2026/10/16/statistics-collinearity-in-regression/ –
library(knitr)
library(ggplot2)
library(dplyr)
library(tidyr)
library(broom)
Problemă
Când efectuați o analiză de regresie, puteți întâlni doi sau mai mulți predictori care sunt foarte corelați. Aceasta se numește coliniaritate sau multicoliniaritate. Poate cauza probleme în estimarea coeficienților de regresie și interpretarea rezultatelor.
În această postare, voi arăta modul în care coliniaritatea poate afecta analiza regresiei, cum să detectăm coliniaritatea și cum să o faceți.
Exemplu: un predictor este o funcție liniară a altui predictor
Să simulăm datele cu următoarele variabile:
X1: o variabilă aleatorie extrasă dintr-o distribuție normală cu medie 0 și abatere standard 1.X2: o altă variabilă aleatoare extrasă dintr-o distribuție normală cu media 0 și abaterea standard 1, independent deX1.Z: o variabilă legată liniar deX2definit caZ = 5*X2 + noiseunde zgomotul este extras dintr-o distribuție normală cu medie 0 și abatere standard 1.Y: o combinație liniară aX1şiX2plus zgomot, definit caY = 3*X1 + 2*X2 + noiseunde zgomotul este extras dintr-o distribuție normală cu medie 0 și abatere standard 1.
set.seed(123)
n <- 100
X1 <- rnorm(n, mean = 0, sd = 1)
X2 <- rnorm(n, mean = 0, sd = 1)
Z <- 5 * X2 + rnorm(n, mean = 0, sd = 1)
Y <- 3 * X1 + 2 * X2 + rnorm(n, mean = 0, sd = 1)
Coeficienții de corelație dintre cei trei predictori sunt:
kable(cor(cbind(X1, X2, Z)), caption="Correlation of the predictors")
| X1 | 1,0000000 | -0,0495321 | -0,0730836 |
| X2 | -0,0495321 | 1,0000000 | 0,9814767 |
| Z | -0,0730836 | 0,9814767 | 1,0000000 |
Acum să potrivim două modele de regresie liniară: unul cu X1 şi X2 ca predictori, iar altul cu X1, X2și Z ca predictori. Vom examina apoi modul în care se modifică următoarele valori: coeficienți, erori standard, valori t, valori p, R-pătrat, R-pătrat ajustat.
fit1 <- lm(Y ~ X1 + X2)
fit2 <- lm(Y ~ X1 + X2 + Z)
coef_results <- rbind(
  tidy(fit1) %>% mutate(model = "fit1"),
  tidy(fit2) %>% mutate(model = "fit2")
)
# move model to the first column
coef_results <- coef_results %>% select(model, everything())
# now R-squared and adjusted R-squared
rsq_results <- rbind(
  glance(fit1) %>% mutate(model = "fit1"),
  glance(fit2) %>% mutate(model = "fit2")
) %>%
  select(model, everything())
kable(coef_results, caption = "The coefficients and statistics")
| potrivi1 | (Intercepta) | -0,0270771 | 0,1058626 | -0,2557758 | 0,7986656 |
| potrivi1 | X1 | 2,9521917 | 0,1154749 | 25,5656651 | 0,0000000 |
| potrivi1 | X2 | 2,0448517 | 0,1090059 | 18,7590842 | 0,0000000 |
| potrivi2 | (Intercepta) | -0,0193261 | 0,1073437 | -0,1800395 | 0,8575011 |
| potrivi2 | X1 | 2,9445494 | 0,1168766 | 25.1936688 | 0,0000000 |
| potrivi2 | X2 | 2,3331532 | 0,5743463 | 4,0622761 | 0,0000993 |
| potrivi2 | Z | -0,0573870 | 0,1122308 | -0,5113302 | 0,6102939 |
kable(rsq_results, caption = "The goodness of fit")
| potrivi1 | 0,9082614 | 0,9063699 | 1,047502 | 480,1763 | 0 | 2 | -145,0117 | 298,0234 | 308,4441 | 106,4342 | 97 | 100 |
| potrivi2 | 0,9085106 | 0,9056516 | 1,051513 | 317,7673 | 0 | 3 | -144,8757 | 299,7514 | 312,7773 | 106,1452 | 96 | 100 |
După cum arată rezultatele, primul model, fit1surprinde aproximativ relația reală în datele simulate, iar ambii coeficienți sunt foarte semnificativi statistic.
Adăugând Z la modelul de regresie produce mai multe modificări: (1) coeficientul pt X2
devine mai mică, (2) eroarea sa standard crește de peste cinci ori și (3) valoarea p pentru testul coeficientului crește în consecință substanțial. În general, R-pătratul modelului se modifică puțin, dar valorile sale AIC și BIC cresc, sugerând că modelul cu trei predictori este mai puțin favorabil decât modelul cu doi predictori.
Pe scurt, includerea unui predictor care este foarte corelat cu un predictor existent reduce semnificația statistică a predictorului existent.
Exemplu: doi predictori cu niveluri diferite de corelație
Acum să simulăm seturi de date care conțin două variabile cu niveluri diferite de corelație. Vom folosi descompunerea Cholesky pentru a simula datele.
Mai întâi, să scriem o funcție care simulează date pentru un coeficient de corelație specificat:
simulate_correlated_data<-function(rho, n=100, seed=NULL) {
  if(is.null(seed)) {
    seed < Sys.time()
  }
  set.seed(seed)
  x <- rnorm(n)
  z <- rnorm(n)
  y <- rho*x + sqrt(1-rho^2)*z
  return(cbind(x,y))
}
Acum să simulăm cinci seturi de date cu corelații țintă de 0,1, 0,3, 0,5, 0,8 și 0,95 între cei doi predictori. De asemenea, vom face ca ambii predictori să contribuie la variabila răspuns, astfel încât să putem examina modul în care diferitele niveluri de corelație afectează potrivirea regresiei:
n<-100
rhos<-c(0.1, 0.3, 0.5, 0.8, 0.95)
simulated_data <- lapply(rhos, simulate_correlated_data, n=n)
# let's calculate the correlation coefficients for the simulated data
simulated_rhos<-sapply(simulated_data, function(d) cor(d(,"x"),d(, "y")))
kable(cbind(expected_rho=rhos, actual_rho=simulated_rhos))
| 0,10 | -0,0271945 |
| 0,30 | 0,3337500 |
| 0,50 | 0,5365344 |
| 0,80 | 0,8167663 |
| 0,95 | 0,9624687 |
Coeficientul de corelație, rho, din fiecare set de date simulat poate să nu se potrivească exact cu valoarea specificată din cauza eșantionării aleatorii, dar putem totuși examina modul în care nivelul de corelație afectează regresia.
 fits <- lapply(simulated_data, function(d) {
          x1<-d(,"x")
          x2<-d(, "y")
          y <- 10*x1 + 3*x2 + rnorm(n)
          fit<-lm(y~x1 + x2)
          return(fit)
          }
          )
coef_results<-lapply(seq_along(rhos),
                     function(i) {
                       tidy(fits((i))) %>%
                         mutate(rho = rhos(i)) %>%
                         select(rho, everything())
                     }
                     )
coef_results <- do.call(rbind, coef_results)
kable(coef_results, caption = "Regression statistics with different correlation strengths among predictors")
| 0,10 | (Intercepta) | 0,1545731 | 0,1093261 | 1,4138713 | 0,1606012 |
| 0,10 | x1 | 10.0038407 | 0,1047198 | 95,5296414 | 0,0000000 |
| 0,10 | x2 | 3,0724520 | 0,1118900 | 27.4595781 | 0,0000000 |
| 0,30 | (Intercepta) | 0,0349345 | 0,1183168 | 0,2952627 | 0,7684243 |
| 0,30 | x1 | 9,8936718 | 0,1339565 | 73,8573235 | 0,0000000 |
| 0,30 | x2 | 3,0068927 | 0,1113956 | 26,9929282 | 0,0000000 |
| 0,50 | (Intercepta) | 0,1417142 | 0,0972655 | 1,4569831 | 0,1483507 |
| 0,50 | x1 | 10,0727790 | 0,1156101 | 87,1271918 | 0,0000000 |
| 0,50 | x2 | 2,9767374 | 0,1173528 | 25.3657122 | 0,0000000 |
| 0,80 | (Intercepta) | -0,0609381 | 0,0979742 | -0,6219812 | 0,5354135 |
| 0,80 | x1 | 10,3154854 | 0,1709446 | 60,3440164 | 0,0000000 |
| 0,80 | x2 | 2,7154226 | 0,1638409 | 16,5735364 | 0,0000000 |
| 0,95 | (Intercepta) | -0,1158642 | 0,0971670 | -1,1924234 | 0,2360041 |
| 0,95 | x1 | 10,0497393 | 0,3537788 | 28.4068467 | 0,0000000 |
| 0,95 | x2 | 2.9023068 | 0,3443712 | 8,4278435 | 0,0000000 |
Să reprezentăm toate valorile:
coef_results <- coef_results %>%
    mutate(rho = factor(rho)) %>%
    pivot_longer(
      cols = estimate:p.value,
      names_to = "metric",
      values_to = "value"
    )
plt <- ggplot(coef_results, aes(x=rho, y=value)) +
      geom_point(aes(color=term)) +
      facet_wrap(~ metric, ncol=2, scales="free_y") +
      theme(legend.position = "top")
plt
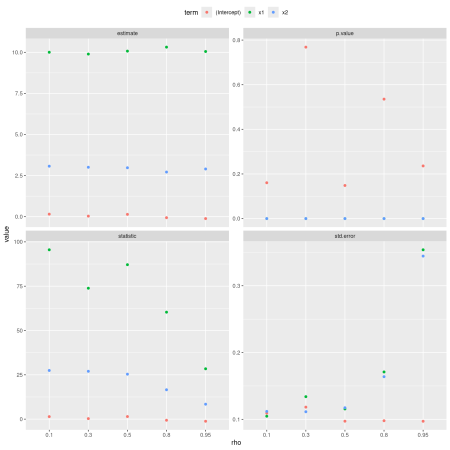
Graficele arată următoarele modele pe măsură ce corelația dintre predictori crește:
- Coeficienții estimați se modifică puțin, deși rămân unele variații.
- Valorile p pentru ambii predictori rămân foarte mici.
- Statisticile testului devin mai mici pe măsură ce rho crește.
- Erorile standard cresc pe măsură ce rho crește.
- Pe baza ultimelor două observații, valorile p pentru predictori ar trebui să devină mai mari, adică mai puțin semnificative.
Pe scurt, atunci când predictorii dintr-o regresie sunt corelați, testul pentru fiecare coeficient devine mai puțin semnificativ statistic, chiar dacă mărimile coeficienților rămân apropiate de valorile utilizate pentru simularea datelor.
La pachet
- Când un predictor,
Zeste o funcție liniară a unui alt predictor,Xși nu are nicio relație directă cu variabila răspuns, inclusivZface testul pentru predictorul adevăratXmai puțin semnificativă statistic. Coeficientul pentruZ
poate să nu fie semnificativă deoarece, după contabilizareX,Znu are efect asupraY. - Când doi predictori afectează ambii
Ysemnificația statistică a coeficienților lor scade pe măsură ce corelația dintre predictori crește, chiar dacă mărimile coeficienților pot rămâne apropiate de valorile adevărate.
Luate împreună, aceste exemple sugerează că este posibil să doriți să excludeți anumite variabile din regresie, cu excepția cazului în care știți că acestea afectează răspunsul sau doriți să examinați efectele altor predictori după ce ați controlat acele variabile.
– https://fortune9.netlify.app/2026/10/16/statistics-collinearity-in-regression/ –
