(Acest articol a fost publicat pentru prima dată pe DataGeeekși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta problema legată de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
Atunci când se prognozează active financiare cu volatilitate ridicată, cum ar fi Bitcoin (BTC-USD), modelele standard de predicție de punct – indiferent dacă ARIMA clasică sau rețelele neuronale profunde – sunt adesea insuficiente. O estimare punctuala iti spune unde modelul se așteaptă ca prețul să meargă, dar ignoră complet schimbările de regim de piață și schimbarea nivelurilor de risc.
În acest articol, construim o conductă de prognoză end-to-end în R care se combină Învățare automată (Multi-Layer Perceptron prin brulee şi tidymodels) pentru predicția tendinței direcționale cu Econometrie financiară (GJR-GARCH prin rugarch) pentru a genera limite de încredere dinamice, ajustate în funcție de volatilitate.
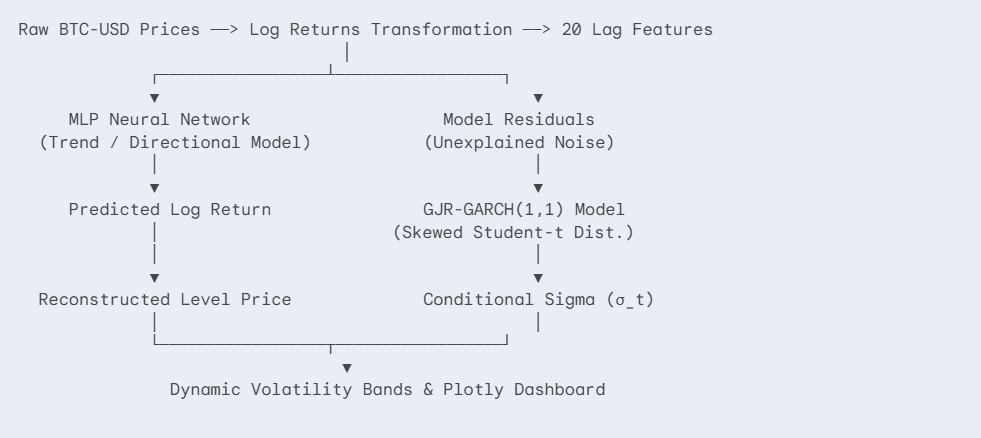
Privire de ansamblu asupra arhitecturii
În loc să încercăm să prognozăm în mod direct prețurile nivelate – ceea ce introduce probleme de non-staționaritate – conducta noastră operează pe jurnalul se întoarce și reconstruiește dinamic traiectorii prețurilor.

Decizii arhitecturale cheie și justificarea metodologică
1. Modelarea jurnalului de returnări în loc de prețuri de nivel
Prevederea directă a prețurilor brute creează adesea rezultate false de regresie, deoarece seriile de prețuri sunt nestaționare. Prin transformarea seriei de prețuri în jurnalul se întoarce:
Această transformare atinge staționaritatea, făcând variabila țintă potrivită pentru antrenamentul rețelei neuronale. Previziunile efective ale prețurilor sunt reconstruite la momentul testării prin exponențiere cumulativă:
2. Învățare profundă pentru tendință: Perceptron cu mai multe straturi (brulee)
Folosim o arhitectură MLP cu 2 straturi (32, 16) initializat prin intermediul tidymodels cadru.
- Caracteristici de întârziere: Furnizăm 20 de zile de returnări de jurnal întârziate pentru a captura autocorelația pe termen scurt și mediu.
- Normalizări și eliminarea variației zero: Manipulat într-un mediu curat
recipesconductă pentru a preveni scurgerea datelor
3. Modelarea econometrică a volatilității: GJR-GARCH(1,1) pe reziduurile rețelei neuronale
Modelele de învățare automată captează media condiționată, dar reziduurile acestora, mai conțin clustering de volatilitate—perioade de turbulențe mari urmate de turbulențe mari și perioade de calm urmate de calm.
Pentru a modela această varianță condiționată (), ne potrivim a GJR-GARCH(1,1) model privind reziduurile de antrenament MLP:
- De ce GJR-GARCH față de GARCH standard? Piețele criptografice prezintă efecte de pârghie: scăderile de preț provoacă adesea o volatilitate de panică mai mare decât creșterile echivalente ale prețurilor. Termenul indicator surprinde această asimetrie ().
- De ce
garchOrder = c(1, 1)? Comanda(1,1)specifică un singur decalaj pentru componenta ARCH () și un singur decalaj pentru componenta GARCH (). Literatura empirică demonstrează că un singur întârziere captează marea majoritate a persistenței volatilității fără supraadaptare. - De ce Skewed Student-t (
sstd) Distributie? Randamentele Bitcoin încalcă ipotezele de distribuție normală Gauss. Ele afișează cozi grase (evenimentele extreme apar frecvent) și asimetrie (distribuție asimetrică). Thesstddistribuția modelează în mod explicit atât cozi grele, cât și asimetrie. - Selecția Solverului: Folosim
solver = "hybrid"înrugarchsă combine algoritmi de optimizare, asigurând convergența chiar și în cazul parametrilor de distribuție complexi.
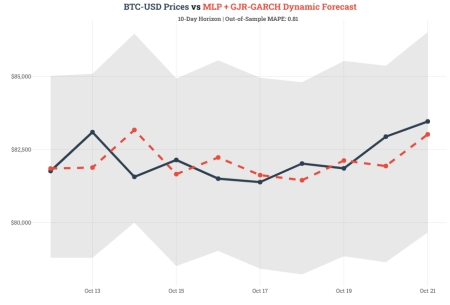
Când piața este liniștită, aceste limite de încredere se contractă automat. În timpul regimurilor volatile, limitele se extind, oferind mai degrabă o anvelopă probabilistică realistă decât intervale de încredere statice, neinformative.
Implementarea completă a R
Mai jos este scriptul R complet, autonom, care implementează pipeline-ul complet folosind tidymodels, brulee, rugarchși plotly.
# Integrated Forecasting Pipeline with tidymodels, yardstick, and plotly
library(tidymodels)
library(timetk)
library(brulee)
library(modeltime)
library(tidyquant)
library(plotly)
library(scales)
library(glue)
library(ggtext)
library(rugarch) # Added for GJR-GARCH volatility modeling

# 1. Fetch Data & Calculate Log Returns
df_raw <- tq_get("BTC-USD") %>%
  select(date, close) %>%
  filter(date >= last(date) - months(24)) %>%
  drop_na() %>%
  mutate(log_ret = log(close / lag(close))) %>%
  drop_na()

# 2. Add Lag Features on Log Returns
df_prepared <- df_raw %>%
  tk_augment_lags(log_ret, .lags = 1:20) %>%
  drop_na()

# 3. Time Series Split (10 Assessment Window)
split <- time_series_split(
  df_prepared,
  assess = 10,
  cumulative = TRUE
)

df_train <- training(split)
df_test  <- testing(split)

# 4. Recipe Setup (Predict Log Return, Not Level Price)
recipe_mlp <- recipe(log_ret ~ ., data = df_train) %>%
  step_rm(date, close) %>%
  step_dummy(all_nominal_predictors()) %>%
  step_zv(all_predictors()) %>%
  step_normalize(all_numeric_predictors())

# modeltime::naive_reg() requires the date column as a predictor to parse the time index
recipe_naive <- recipe(log_ret ~ date, data = df_train)

# 5. Model Specifications
model_spec_mlp <- mlp(
  hidden_units = c(32, 16),
  epochs = 100,
  dropout = 0.05,
  learn_rate = 0.005
) %>%
  set_engine("brulee") %>%
  set_mode("regression")

model_spec_naive <- naive_reg() %>%
  set_engine("naive")

# 6. Workflow Construction & Model Fitting
workflow_mlp <- workflow() %>%
  add_recipe(recipe_mlp) %>%
  add_model(model_spec_mlp) %>%
  fit(df_train)

workflow_naive <- workflow() %>%
  add_recipe(recipe_naive) %>%
  add_model(model_spec_naive) %>%
  fit(df_train)

# 7. Predictions & Price Reconstruction (Reference Code Logic)
preds_mlp_ret   <- predict(workflow_mlp, df_test)
preds_naive_ret <- predict(workflow_naive, df_test)

df_results <- df_test %>%
  mutate(
    yesterday_close = lag(close, default = first(close)),
    actual      = close,
    pred_brulee = yesterday_close * exp(preds_mlp_ret$.pred),
    pred_naive  = yesterday_close * exp(preds_naive_ret$.pred)
  )

# ==============================================================================
# 7.5. GJR-GARCH (Skewed Student-t) Dynamic Volatility & Confidence Bands
# ==============================================================================
# Calculate MLP residuals on the training set
train_preds_mlp <- predict(workflow_mlp, df_train)$.pred
train_residuals <- df_train$log_ret - train_preds_mlp

# GJR-GARCH(1,1) specification with Skewed Student-t distribution for fat-tails and asymmetry
garch_spec <- ugarchspec(
  variance.model = list(model = "gjrGARCH", garchOrder = c(1, 1)),
  mean.model = list(armaOrder = c(0, 0), include.mean = FALSE),
  distribution.model = "sstd"
)

# Fit GJR-GARCH model on training residuals
garch_fit <- ugarchfit(spec = garch_spec, data = train_residuals, solver = "hybrid")

# Forecast conditional volatility for the 10-day test horizon
garch_fore <- ugarchforecast(garch_fit, n.ahead = 10)
dynamic_sigmas <- sigma(garch_fore) # 10-day dynamic conditional standard deviations

# Attach dynamic standard deviations to test results and compute dynamic confidence bounds
df_results <- df_results %>%
  mutate(
    conditional_sigma = as.vector(dynamic_sigmas),
    # Dynamically scaled confidence bounds in price space (± 1.96 * conditional_sigma)
    conf_hi = pred_brulee * exp(1.96 * conditional_sigma),
    conf_lo = pred_brulee * exp(-1.96 * conditional_sigma)
  )

# 8. Accuracy Table Construction (Yardstick on Original Price Scale)
accuracy_table <- tibble(
  .model_id   = c(1, 2),
  .model_desc = c("BRULEE MLP (32, 16) + GJR-GARCH", "NAIVE"),
  rmse        = c(rmse_vec(df_results$actual, df_results$pred_brulee),
                  rmse_vec(df_results$actual, df_results$pred_naive)),
  rsq         = c(rsq_vec(df_results$actual, df_results$pred_brulee),
                  rsq_vec(df_results$actual, df_results$pred_naive)),
  mape        = c(mape_vec(df_results$actual, df_results$pred_brulee),
                  mape_vec(df_results$actual, df_results$pred_naive)),
  mae         = c(mae_vec(df_results$actual, df_results$pred_brulee),
                  mae_vec(df_results$actual, df_results$pred_naive))
)

# Print Model Comparison Table
cat("=== MODEL ACCURACY EVALUATION TABLE (PRICE SCALE) ===\n")
cat(knitr::kable(accuracy_table, digits = 4, format = "simple"), sep = "\n")

# 9. Modern Interactive Plotly Visualization (Reference Style)
brulee_mape <- accuracy_table$mape(1)
df_eval <- df_results

# Custom Hover Text Data Frames
df_plot_actual <- df_eval %>% select(date, actual)  %>% mutate(text_actual = glue("Actual Price: {scales::dollar(actual, accuracy = 0.01)}
Date: {format(date, '%b %d, %Y')}"))
df_plot_pred   <- df_eval %>% select(date, pred_brulee) %>% mutate(text_pred   = glue("AI Prediction Price: {scales::dollar(pred_brulee, accuracy = 0.01)}
Date: {format(date, '%b %d, %Y')}"))
df_plot_hi     <- df_eval %>% select(date, conf_hi) %>% mutate(text_hi     = glue("GJR-GARCH Upper Bound: {scales::dollar(conf_hi, accuracy = 0.01)}
Date: {format(date, '%b %d, %Y')}"))
df_plot_lo     <- df_eval %>% select(date, conf_lo) %>% mutate(text_lo     = glue("GJR-GARCH Lower Bound: {scales::dollar(conf_lo, accuracy = 0.01)}
Date: {format(date, '%b %d, %Y')}"))

# Build Base GGPlot Layer
p <- ggplot() +
  geom_ribbon(data = df_eval, aes(x = date, ymin = conf_lo, ymax = conf_hi), fill = "#808080", alpha = 0.18) +
  geom_point(data = df_plot_hi, aes(x = date, y = conf_hi, text = text_hi), color = "transparent", alpha = 0, size = 3) +
  geom_point(data = df_plot_lo, aes(x = date, y = conf_lo, text = text_lo), color = "transparent", alpha = 0, size = 3) +
  geom_line(data = df_plot_actual, aes(x = date, y = actual), color = "#2c3e50", linewidth = 1.2) +
  geom_point(data = df_plot_actual, aes(x = date, y = actual, text = text_actual), color = "#2c3e50", size = 2) +
  geom_line(data = df_plot_pred, aes(x = date, y = pred_brulee), color = "#e74c3c", linetype = "dashed", linewidth = 1.2) +
  geom_point(data = df_plot_pred, aes(x = date, y = pred_brulee, text = text_pred), color = "#e74c3c", size = 2) +
  scale_y_continuous(labels = dollar_format(accuracy = 1)) +
  labs(
    x = "", y = "",
    title = paste0(
      "BTC-USD Prices vs ",
      "MLP + GJR-GARCH Dynamic Forecast
",
      "10-Day Horizon | Out-of-Sample MAPE: ", round(brulee_mape, 2), ""
    )
  ) +
  theme_minimal() +
  theme(
    plot.title = element_markdown(hjust = 0.5, face = "bold"),
    plot.background = element_rect(fill = "#ffffff", color = NA),
    panel.background = element_rect(fill = "#ffffff", color = NA),
    panel.grid.minor = element_blank()
  )

# Typography Settings & Plotly Output
font_family <- list(family = "Roboto Slab, Sans-Serif", size = 16)
label_font  <- list(font = list(family = "Roboto Slab, Sans-Serif", size = 13))

ggplotly(p, tooltip = "text") %>%
  style(hoverlabel = label_font) %>%
  layout(font = font_family)
Concluzie
Combinarea învățării automate cu econometria tradițională produce un sistem hibrid care depășește limitările ambelor domenii:
- Învățare automată surprinde relații neliniare și mișcări de tendințe.
- Econometrie (GARCH) furnizează parametri statistici explici pentru gruparea incertitudinii și volatilității.
Rezultatul rezultat oferă pachete de risc realiste și dinamice, care evoluează odată cu schimbarea regimurilor de piață, oferind comercianților și analiștilor cantitativi un cadru robust pentru luarea deciziilor conștientă de volatilitate.
