(Acest articol a fost publicat pentru prima dată pe Data Science Gutsși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta problema legată de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
În octombrie 2020 am scris despre platypus, un pachet R pentru detectarea obiectelor și segmentarea imaginii: YOLOv3 și U-Net în câteva rânduri de R, pe deasupra keras şi tensorflow pachete. Oamenii l-au folosit. A adunat 134 de stele și o coadă de probleme – apoi a încetat să funcționeze în liniște și am încetat să le răspund.
# install.packages("remotes")
remotes::install_github("maju116/rplatypus")
Această postare este despre motivul pentru care a trebuit să fie rescris mai degrabă decât remediat, ce este în ea acum și unde merge seria de postări care urmează.
De ce s-a stricat cel vechi
R keras şi tensorflow pachetele nu sunt legături la o bibliotecă C++. Sunt poduri, prin reticulateîntr-o instalare Python a TensorFlow – și în 2020 asta a fost cel Instalare Python, cea partajată cu tot restul de pe mașină. Upgrade-ul numpy pentru un proiect fără legătură și o sesiune R folosind platypus ar putea opri încărcarea. Eșecul nu a apărut niciodată în codul pachetului meu, ceea ce a făcut ca suportul să fie mizerabil: rapoartele de erori erau despre Python-ul altor persoane.
A doua problemă este cea care de fapt m-a făcut să mă opresc. ornitorincul stătea pe două straturi pe care nu le controlam: R keras şi tensorflow pachete peste TensorFlow însuși. Când TensorFlow s-a schimbat în Python, pachetele R au trebuit să ajungă din urmă înainte ca platypus să poată, iar asta a durat adesea foarte mult timp. Până când au făcut-o, pachetul meu a fost blocat, cu probleme pe care nu le-am putut rezolva din partea mea. După destule, mi-am pierdut voința de a continua să lucrez la asta.
Două lucruri s-au schimbat de atunci și, împreună, elimină ambele probleme de la rădăcină, mai degrabă decât petice în jurul lor.
reticulat a invatat sa izoleze. Începând cu versiunea 1.41, un pachet își declară cerințele Python cu py_require()și reticulate construiește un mediu privat pentru ei cu UV, stocat în cache și partajat cu nimeni. Nu mai există niciun Python comun pentru două pachete pentru care să se lupte. rplatypus nu atinge niciodată un Python pe care altcineva îl folosește – iar persoana care îl instalează nu alege niciodată un interpret, nu activează nimic sau nu se potrivește cu o versiune. Primul apel care are nevoie de motor construiește mediul; fiecare apel după aceea îl reutiliza. Și nu mai există niciun wrapper R între ele: rplatypus își numește propriul motor, pe care îl eliberez singur, așa că nimic nu așteaptă ca altcineva să-l ajungă din urmă.
Lumea imagistică medicală s-a instalat pe PyTorch. MONAI, nnU-Net, TorchIO, timm, codificatoarele pre-antrenate și modelele de bază – toate acestea sunt PyTorch. TensorFlow pentru imagini medicale s-a încheiat efectiv, iar TensorFlow 2.9 la care era fixat vechiul motor nici măcar nu se instalează pe Python 3.12. A rămâne oricum ar fi însemnat rescrierea, pe un backend fără viitor în domeniu.
S-a schimbat și un al treilea lucru. Nu remediază vechiul eșec, dar acesta este motivul pentru care s-a întâmplat rescrierea în loc să rămână o idee bună: scrierea unui pachet a devenit mult mai ieftină. În 2020 am scris eu însumi fiecare rând de ornitorinc, iar părțile care fac un pachet demn de încredere – teste, documentație, mesaje de eroare care spun ce a mers prost – au fost părțile pentru care nu am mai avut timp. De data aceasta am lucrat cu un agent de codare AI, Claude Code.
Vreau să fiu precis ce înseamnă asta, pentru că „AI mi-a scris pachetul” nu este. Deciziile au fost ale mele: pentru ce este pachetul, pe ce seturi de date să-l măsoare, ce ar trebui să refuze și ce trebuie să arate un rezultat înainte de a intra în documentație – fiecare număr din această serie a fost măsurat, nu generat. Ceea ce a schimbat agentul a fost costul tuturor lucrurilor în jurul acelor decizii: scrierea testelor, păstrarea a două pachete în două limbi în pas, urmărirea unui control eșuat prin reticulate, uv și CUDA. Aceasta este exact munca care obișnuia să încheie proiecte secundare ca acesta. Rescrierea a durat aproximativ o lună.
Deci, calculul s-a mutat la pyplatypus, un motor Python pe PyTorch, iar rplatypus este pachetul R de deasupra acestuia. Divizarea este deliberată:
- Motorul este in Pythonpentru că acolo sunt deja modelele, greutățile și bibliotecile medicale. O bază de cod de întreținut și tot ce are PyTorch este la îndemână.
- Produsul este in Rpentru că acolo este decalajul. Citirea și combinarea măștilor, trasarea, compararea modelelor, analiza în jurul rețelei – acea parte este simplu R și nu are nevoie de Python deloc.
Am considerat R-ul nativ torchcare leagă libtorch direct și nu are nevoie de Python. Pentru o persoană care să mențină acest lucru în serile lor, ar fi însemnat să scrie de două ori fiecare arhitectură, pierderi și conducte de date și să renunțe la fiecare greutate preantrenată din ecosistemul Python.
pyplatypus: același motor, de la Python
Motorul nu este instalat ascuns. pyplatypus este un pachet pe PyPI în sine – și el a început viața în 2022 pe TensorFlow și a fost rescris împreună – și dacă lucrezi în Python îl poți folosi direct:
pip install "pyplatypus(hub)"
Exemplul de mai jos rulează din ambele limbi, dintr-un singur fișier.
Cele două sunt dezvoltate împreună și într-o ordine fixă. O caracteristică aterizează mai întâi în motor, motorul este publicat în PyPI și abia apoi rplatypus se mută la el – fiecare lansare a pachetului R fixează o versiune exactă a pyplatypus, așa că nu se poate rupe deoarece motorul s-a schimbat sub el. De asemenea, împărtășesc un singur format de configurare: același fișier YAML descrie același experiment, indiferent de limbă îl citește, astfel încât un utilizator R și un utilizator Python se pot înmâna reciproc.
Așa este și acest serial scris. Exemplele sunt în R, pentru că acolo este decalajul și fiecare postare arată cum arată același pas din Python.
Decalajul
Iată partea care m-a convins că merită făcută. R are instrumente excelente pentru lectură imagini medicale – RNifti, oro.dicom, divest – și o stivă sănătoasă de învățare profundă. Aproape nimic nu li se alătură. Când am verificat în septembrie, CRAN Task View for Medical Image Analysis (ultima actualizare în august 2025) nu a enumerat niciun pachet de deep learning.
Deci, rplatypus este menit să fie piesa care lipsește: nu un înveliș în jurul unei biblioteci Python pe care trebuie să o înveți, ci un pachet R care se întâmplă să calculeze în Python.
O mască, fără antrenament nimic
Cea mai rapidă modalitate de a vedea dacă un pachet face ceva util este să împrumuți un model pe cineva deja instruit. rplatypus publică ponderi după nume – aici un U-Net instruit pe Data Science Bowl 2018, același set de date nuclee pe care l-am folosit pe acest blog în 2020.
Dosarul nuclei/ deține patru imagini de microscopie în aspectul propriu al setului de date – un director per imagine, cu images/ şi masks/ interior.
library(rplatypus)

spec <- platypus_spec(
  data = segmentation_data("nuclei", "nuclei", colormap = binary_colormap),
  models = list(u_net("nuclei", input_shape = c(256, 256), blocks = 4, filters = 16,
                      weights = "dsbowl-unet", fit = FALSE))
)
fit <- platypus_fit(spec, verbose = FALSE)
masks <- predict(fit, split = "validation")
dim(masks)
#> (1)   4 256 256
Patru imagini, 256 x 256 pixeli, o etichetă de clasă per pixel. Acesta a rulat pe procesor, fără GPU; platypus_device() vă spune dacă al dvs. va folosi unul și de ce nu dacă nu poate.
images <- list.files("nuclei", pattern = "(.)png$", recursive = TRUE, full.names = TRUE)
images <- read_images(grep("/images/", images, value = TRUE), size = c(256, 256))
plot_masks(images, prediction = masks, colormap = binary_colormap)
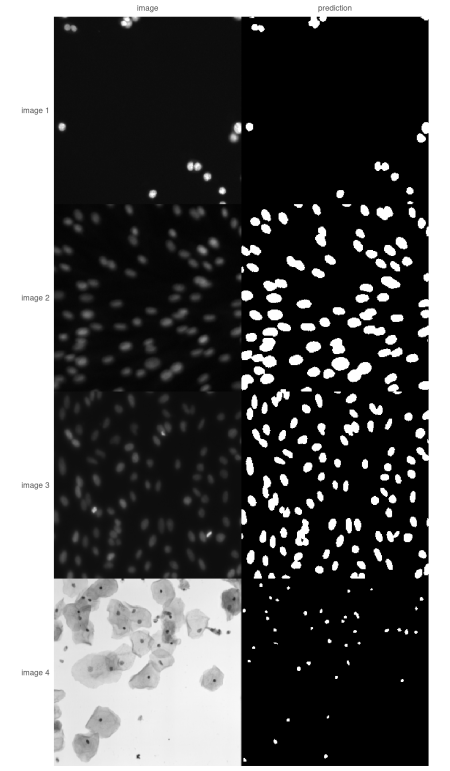
Figura 1: Nuclee găsite de publicat dsbowl-unet greutăți, pe patru imagini de feluri diferite.
Primele trei sunt imagini cu fluorescență, iar nucleele ies ca pete curate. A patra este o imagine în câmp luminos a celulelor colorate, iar modelul găsește pete – micile nuclee întunecate din interiorul celulelor. Acesta este tipul greu de imagine din acest set de date, iar următoarea postare o analizează îndeaproape.
Nu există niciun scor aici și asta este intenționat. Aceste patru imagini provin din aceeași colecție pe care au fost antrenate greutățile, așa că orice număr măsurat pe ele ar flata modelul. Numerele care înseamnă ceva au fost măsurate pe o împărțire susținută atunci când ponderile au fost publicate și available_weights() spune ce sunt ei și ce nu poate face modelul – de exemplu, că este a semantic model, așa că nucleele care se ating revin ca o singură regiune și o numărare luată din ele ar fi greșită.
Același lucru dintr-un fișier
Aceeași specificație poate trăi într-un fișier. Acesta a început ca save_spec(spec, "nuclei.yaml")cu listele ordonate manual:
task: semantic_segmentation
data:
  train_path: nuclei
  validation_path: nuclei
  colormap: ((0, 0, 0), (255, 255, 255))
models:
- name: nuclei
  architecture: u_net
  input_shape: (256, 256)
  blocks: 4
  filters: 16
  weights: dsbowl-unet
  fit: false
Citirea înapoi oferă exact obiectul construit din argumentele de mai sus:
identical(as.list(platypus_spec("nuclei.yaml")), as.list(spec))
#> (1) TRUE
Aşa platypus_fit(platypus_spec("nuclei.yaml")) face tot ce a făcut codul R și nimic din aval nu poate spune în ce fel a fost scrisă specificația. Motorul Python citește același fișier:
from pyplatypus import build_engine, from_yaml

engine = build_engine(from_yaml("nuclei.yaml"))
engine.fit()  # with `fit: false` this loads the published weights instead of training
masks = engine.predict("nuclei", split="validation")
Un fișier de configurare și un script R descriu același experiment și oricare poate fi predat unui coleg – indiferent de limba în care lucrează.
Ce este în el
Pe scurt, pentru că majoritatea acestora primesc propria postare:
- Segmentarea2D și 3D: U-Net, U-Net++, Res-U-Net și LinkNet, unsprezece pierderi, cinci metrici care pot lăsa fundalul afară – ceea ce contează când fundalul este cea mai mare parte a imaginii.
- Clasificare – o etichetă pentru o imagine întreagă, punctată mai degrabă de AUC decât de acuratețe, deoarece un clasificator care răspunde „nicio constatare” unde 3% au un punctaj de 0,97 și nu a învățat nimic.
- Detectarea obiectelor cu YOLOv3, cu ancore montate pe cutiile tale, mai degrabă decât împrumutate de la COCO.
- Segmentarea instanțelor – un număr de obiecte în loc de o zonă.
- Volumele: NIfTI și DICOM în, cu spațierea voxeli gestionată, o împărțire în funcție de pacient și nu de felie și rezultă în mililitri mai degrabă decât în voxeli.
- Un scor pe caz, nu unul pe set de datedeci cea mai proastă imagine are un nume.
- Refuzuri înainte de o zi irosită: o hartă de culori care nu se potrivește cu niciuna dintre măștile tale, canale într-o ordine pe care nu ai intenționat-o, o serie DICOM cu o felie lipsă – fiecare oprit înainte de antrenament, după nume.
- O specificație – din argumentele R sau dintr-un fișier YAML, citit în același mod de către motorul Python.
Referința completă și șapte viniete, șase dintre ele precalculate din rulări reale, sunt la maju116.github.io/rplatypus.
Aici începe pachetul, nu unde se termină. Familia U-Net, YOLOv3 și clasificatorul sunt primele modele din ea, nu singurele care vor fi: vin mai multe arhitecturi, alături de ceea ce încă mai lipsește – clasificare multi-etichetă, ansamblu, cutii în trei dimensiuni. Care dintre acestea vine primul depinde parțial de ceea ce au nevoie oamenii de fapt, care este încă un motiv pentru întrebarea de la sfârșitul acestei postări.
Ce urmează
Aceasta este prima postare a unei serii. Fiecare dintre următoarele preia un set de date și un lucru pe care m-a învățat măsurarea pe el:
- Nuclei, cinci ani mai târziu – un model cu un zar mediu de 0,855 care are un scor de 0,006 pe trei imagini și de ce media nu ți-a putut spune.
- Clasificare – un clasificator cu o precizie de 0,97 care nu a învățat nimic și de ce acuratețea echilibrată nu îl salvează.
- Celule sanguine și YOLOv3 – ancore și de ce un punct de mAP peste cinci semințe este zgomot.
- volume CT – un zar de 0,88 și volume 12-23% prea mari, ceea ce nu este o contradicție.
- Vasele retiniene – de ce nu puteți redimensiona un vas lățime de nouă pixeli.
- Numărarea nucleelor care se ating – 245 de obiecte sau 180, din aceeași pasă înainte.
- Codificatori preantrenați – măsurat pe trei modalități, în care un encoder cu parametri de 1,9 M învinge ResNet-34 pe două dintre ele.
O întrebare pentru tine
Și încă ceva, deoarece acesta este un loc bun pentru a o spune: îmi caut următorul rol. Dacă echipa ta lucrează la vederea computerizată, imagistica medicală sau orice problemă în care un model trebuie măsurat sincer înainte ca cineva să aibă încredere în el, aș fi bucuros să vorbesc – același e-mail funcționează.
