TD;DR
- Efectuăm un calcul complet al rezervării Chain-Ladder pentru 233 de asigurători dintr-o mână de
polarsexpresii, verificate cu R-urileChainLadderpachet. - Modelul de dezvoltare a unui asigurător se dovedește nemonoton – tipul de model care declanșează potrivirile standard ale curbei parametrice.
- Whittaker-Henderson netezire, nou disponibil ca
scipy.signal.whittaker_hendersonse descurcă cu grație și modifică rezerva estimată cu aproximativ 3%.
O problemă de rezervă, rezolvată fără Excel
Întrebați un actuar cu rezervă cum rulează o scară cu lanț și veți auzi de obicei „Excel” sau numele unui instrument specializat costisitor. Se pare că o bibliotecă modernă de cadre de date o gestionează la fel de bine – în câteva rânduri, pentru sute de companii simultan.
Folosim datele de rezervare a pierderilor CAS, în special altă răspundere linie de activitate (LoB): 233 de asigurători din SUA („GRNAME”), 10 ani de accident (1998–2007), pierderi plătite și suportate la fiecare decalaj de dezvoltare (1-10). Tratăm 2007 drept anul de raportare, adică simulăm o închidere la sfârșitul anului.
După ce citim datele, le pregătim puțin
import polars as pl

# Other Liability Data Set, December 2025
df = pl.read_csv(
    "https://www.casact.org/sites/default/files/2026-03/othliab_pos_98-07.csv"
)
df_triangle = (
    df
    .group_by("GRNAME", "AccidentYear", "DevelopmentLag")
    .agg(pl.sum("IncurredLosses").alias("Incurred"), pl.sum("CumPaidLoss").alias("Paid"))
    .sort("GRNAME", "AccidentYear", "DevelopmentLag")
)
Acesta este încă „triunghiul complet”, adică toate cele 10 întârzieri de dezvoltare pentru toți cei 10 ani de accident. Rețineți că df_triangle nu este într-un format triunghi, ci într-un format de date lung, vezi Tidy Data de Hadley Wickham.
Scară cu lanț în câteva linii de polari
Mecanica este cea manuală: creanțele agregate după anul accident i și decalajul de dezvoltare j (începe de la 1, nu 0), păstrați doar triunghiul din stânga sus (deja observat) și calculați factorii de dezvoltare CL
f^{CL}_j = frac{sum_{i=1998}^{2008-j} C_{i,j}}{sum_{i=1998}^{2008-j} C_{i,j-1}}
separat pentru fiecare companie. În polari acesta este doar un group_by plus câteva ferestre (.over(...)) expresii — nu sunt necesare bucle manuale peste triunghiuri:
def df_2_cl_factors(df, group_by=None):
    g = () if group_by is None else group_by

    cl_factors = (
        df
        .group_by(g + ("AccidentYear", "DevelopmentLag"))
        .agg(pl.sum("Paid"), pl.sum("Incurred"))
        # Filter upper left triangle
        .filter(REPORTING_YEAR >= pl.col("AccidentYear") + pl.col("DevelopmentLag") - 1)
        .sort(g + ("AccidentYear", "DevelopmentLag"))
        .with_columns(
            PreviousPaid=pl.col("Paid").shift(1).over(g + ("AccidentYear")),
            PreviousIncurred=pl.col("Incurred").shift(1).over(g + ("AccidentYear")),
        )
        # Calculate volume-weighted factors per lag
        .group_by(g + ("DevelopmentLag"))
        .agg(
            number_of_years=pl.len(),
            Paid=pl.col("Paid").sum(),
            PreviousPaid=pl.col("PreviousPaid").sum(),
            Incurred=pl.col("Incurred").sum(),
            PreviousIncurred=pl.col("PreviousIncurred").sum(),
        )
        .with_columns(
            f_CL_paid=pl.when(pl.col("PreviousPaid") == 0).then(1).otherwise(pl.col("Paid") / pl.col("PreviousPaid")),
            f_CL_inc=pl.when(pl.col("PreviousIncurred") == 0).then(1).otherwise(pl.col("Incurred") / pl.col("PreviousIncurred")),
        )
        .sort(g + ("DevelopmentLag"))
    )
    return cl_factors

cl_factors = df_2_cl_factors(df_triangle, group_by=("GRNAME"))
Am validat rezultatul împotriva lui R ChainLadder pachet pentru un asigurător, Grinnell Mut Grp, și factorii implicați s-au potrivit.
În continuare, calculăm factorii de dezvoltare Chain-Ladder, din nou atât pentru plătiți, cât și pentru cei suportați, de data aceasta separat pentru fiecare companie. Rețineți că avem grijă să ținem cont doar de stânga sus triunghi, care este ceea ce este de obicei disponibil în practică.
def df_2_cl_factors(df, group_by=None):
    g = () if group_by is None else group_by

    cl_factors = (
        df
        .group_by(g + ("AccidentYear", "DevelopmentLag"))
        .agg(pl.sum("Paid"), pl.sum("Incurred"))
        # Filter upper left triangle
        .filter(REPORTING_YEAR >= pl.col("AccidentYear") + pl.col("DevelopmentLag") - 1)
        .sort(g + ("AccidentYear", "DevelopmentLag"))
        .with_columns(
            PreviousPaid=pl.col("Paid").shift(1).over(g + ("AccidentYear")),
            PreviousIncurred=pl.col("Incurred").shift(1).over(g + ("AccidentYear")),
        )
        # Calculate volume-weighted factors per lag
        .group_by(g + ("DevelopmentLag"))
        .agg(
            number_of_years=pl.len(),
            Paid=pl.col("Paid").sum(),
            PreviousPaid=pl.col("PreviousPaid").sum(),
            Incurred=pl.col("Incurred").sum(),
            PreviousIncurred=pl.col("PreviousIncurred").sum(),
        )
        .with_columns(
            f_CL_paid=pl.when(pl.col("PreviousPaid") == 0).then(1).otherwise(pl.col("Paid") / pl.col("PreviousPaid")),
            f_CL_inc=pl.when(pl.col("PreviousIncurred") == 0).then(1).otherwise(pl.col("Incurred") / pl.col("PreviousIncurred")),
        )
        .sort(g + ("DevelopmentLag"))
    )
    return cl_factors

cl_factors = df_2_cl_factors(df_triangle, group_by=("GRNAME"))
cl_factors.filter(pl.col("GRNAME") == "Grinnell Mut Grp")
┌────────────┬────────────┬────────────┬────────┬───┬──────────┬────────────┬───────────┬──────────┐
│ GRNAME     ┆ Developmen ┆ number_of_ ┆ Paid   ┆ … ┆ Incurred ┆ PreviousIn ┆ f_CL_paid ┆ f_CL_inc │
│ ---        ┆ tLag       ┆ years      ┆ ---    ┆   ┆ ---      ┆ curred     ┆ ---       ┆ ---      │
│ str        ┆ ---        ┆ ---        ┆ i64    ┆   ┆ i64      ┆ ---        ┆ f64       ┆ f64      │
│            ┆ i64        ┆ u32        ┆        ┆   ┆          ┆ i64        ┆           ┆          │
╞════════════╪════════════╪════════════╪════════╪═══╪══════════╪════════════╪═══════════╪══════════╡
│ Grinnell   ┆ 1          ┆ 10         ┆ 59563  ┆ … ┆ 191044   ┆ 0          ┆ 1.0       ┆ 1.0      │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
│ Grinnell   ┆ 2          ┆ 9          ┆ 89554  ┆ … ┆ 172605   ┆ 166116     ┆ 1.727141  ┆ 1.039063 │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
│ Grinnell   ┆ 3          ┆ 8          ┆ 107323 ┆ … ┆ 151543   ┆ 151052     ┆ 1.38351   ┆ 1.003251 │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
│ Grinnell   ┆ 4          ┆ 7          ┆ 106828 ┆ … ┆ 129664   ┆ 131101     ┆ 1.135997  ┆ 0.989039 │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
│ Grinnell   ┆ 5          ┆ 6          ┆ 96179  ┆ … ┆ 105967   ┆ 106851     ┆ 1.088687  ┆ 0.991727 │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
│ Grinnell   ┆ 6          ┆ 5          ┆ 82541  ┆ … ┆ 86134    ┆ 86800      ┆ 1.05192   ┆ 0.992327 │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
│ Grinnell   ┆ 7          ┆ 4          ┆ 64703  ┆ … ┆ 66151    ┆ 66159      ┆ 1.019475  ┆ 0.999879 │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
│ Grinnell   ┆ 8          ┆ 3          ┆ 48924  ┆ … ┆ 49409    ┆ 49457      ┆ 1.008015  ┆ 0.999029 │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
│ Grinnell   ┆ 9          ┆ 2          ┆ 32840  ┆ … ┆ 33029    ┆ 32969      ┆ 1.006343  ┆ 1.00182  │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
│ Grinnell   ┆ 10         ┆ 1          ┆ 15785  ┆ … ┆ 15915    ┆ 15908      ┆ 1.002413  ┆ 1.00044  │
│ Mut Grp    ┆            ┆            ┆        ┆   ┆          ┆            ┆           ┆          │
└────────────┴────────────┴────────────┴────────┴───┴──────────┴────────────┴───────────┴──────────┘
Am validat rezultatul împotriva lui R ChainLadder pachet pentru un asigurător, Grinnell Mut Grp, și factorii implicați potriviți, consultați blocnotesul legat.
Un model care nu joacă frumos
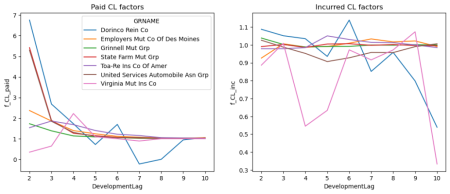
Privind factorii CL ai companiilor individuale, două au ieșit în evidență: modelul plătit al Virginia Mut Ins Co și modelul suportat al Grinnell Mut Grp. Nici unul nu este monoton – un steag roșu, deoarece majoritatea instrumentelor comerciale de rezervare oferă doar potriviri curbe parametrice care sunt strict monotone (pentru a fi corect, potrivirile curbelor parametrice sunt mai mult pentru estimarea factorului de coadă).

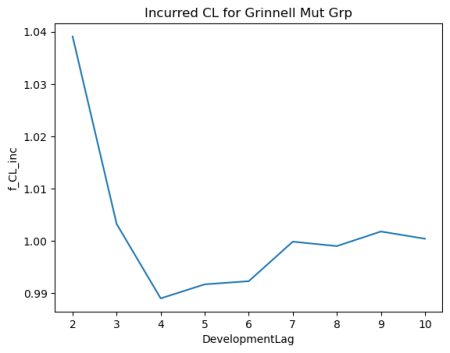
Factorii CL suportați de Grinnell cresc peste 1 devreme, coboară sub 1 (rezervele de caz fiind eliberate, poate subrogare), apoi urcă înapoi peste 1 cu ceva zig-zag în anii următori. O curbă parametrică pur și simplu nu poate reprezenta acel model în formă de șa.
Intră Whittaker-Henderson
Netezirea Whittaker-Henderson (WH) este un netezitor neparametric, penalizat – nu se asumă o formă funcțională, doar un compromis între potrivirea datelor și penalizarea rugozității. Acest compromis este controlat de două butoane: penalizarea order (folosim standardul order=2adică curbura penalizare) și puterea penalizării lambpe care o punem cu ochii.
Se întâmplă să fie o potrivire perfectă aici: factorii de dezvoltare sunt un semnal de timp discret cu pași de timp egali, exact pentru ce a fost concepută netezirea WH (acesta datează de la Georg Bohlmann în 1899 – probabil că ar trebui să se numească Bohlmann-Whittaker-Henderson). Începând cu scipy 1.18, este livrat din cutie ca scipy.signal.whittaker_henderson — dezvăluire completă, am contribuit la implementarea respectivă, așa că s-ar putea să fiu puțin părtinitoare în a găsi scuze pentru ao folosi 
from scipy.signal import whittaker_henderson

f_smooth = whittaker_henderson(
  signal=f_cl_inc, weights=previous_incurred, lamb=1e4
).x
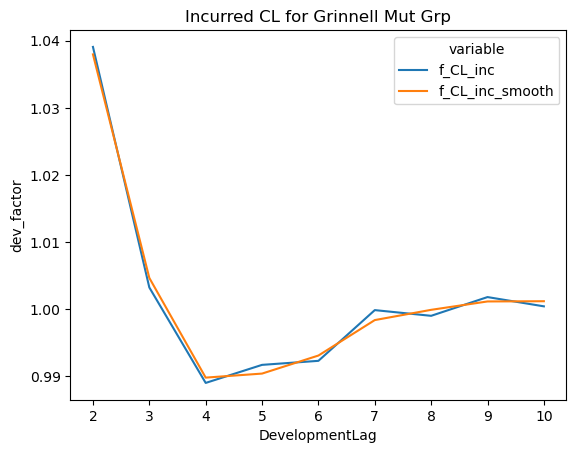
O proprietate clară a netezirii WH: păstrează suma ponderată din eșantion a semnalului, astfel încât factorii neteziți reproduc pierderile observate exact în intervalul ajustat. În afara eșantionului – adică pentru triunghiul din dreapta jos neobservat încă – factorii neteziți și bruti diverg, ceea ce este exact locul în care contează pentru rezervare.
Schimbă rezerva?
Da, un pic:
| anul accidentului | rezerva CL efectuată | rezerva netezită |
| 1998 | 0,0 | 0,0 |
| 1999 | 7.5 | 20.6 |
| 2000 | 37.2 | 39,0 |
| 2001 | 21.5 | 38.3 |
| 2002 | 23.3 | 13.7 |
| 2003 | -124,9 | -118,9 |
| 2004 | -336,1 | -358,5 |
| 2005 | -522,0 | -525,9 |
| 2006 | -482,1 | -456,4 |
| 2007 | 394,4 | 398,2 |
| TOTAL | -981,1 | -950,0 |
Rezerva totală se schimbă cu aproximativ 3% (+31,1) – modestă pentru total, deși anii individuali de accident se deplasează mai mult (unii cu două cifre în termeni procentuali), deoarece netezirea permite vecinilor unui factor să-l îndepărteze de propriul său raport zgomotos.
Dacă comparăm cu pierderile suferite după toți cei 10 ani de dezvoltare – cel mai apropiat proxy pe care îl avem de pierderea finală adevărată – atât CL, cât și CL netezit de WH se dovedesc a o supraestime. CL nenetezit este doar puțin mai aproape.
| suportate | CL final | netezită final |
| 189.901 | 194.067 | 194.098 |
Deci, pentru această companie, netezirea a făcut ca modelul de dezvoltare să fie mai ușor de raționat, dar nu a făcut prognoza mai precisă – diferența (aproximativ 31) este mică în comparație cu 4.582 de erori standard raportate de metoda Mack pentru acest triunghi, așa că nici una dintre metode nu este în mod clar mai bună aici. Un bun memento pentru a verifica împotriva unui holdout ori de câte ori este disponibil unul.
La pachet
- Polars face ca Chain-Ladder wrangling să fie compact și rapid, chiar și în sute de companii simultan.
- Factorii CL ponderați în funcție de volum calculați în polari se potrivesc cu R
ChainLadderpachet exact – întotdeauna liniștitor atunci când schimbați unelte. - Netezirea Whittaker-Henderson este o alternativă flexibilă la potrivirea curbei parametrice ori de câte ori factorii de dezvoltare sunt zgomotoși sau nemonotoni, iar acum este încorporat în scipy. Un model mai neted nu este în mod automat unul mai precis, totuși – verificați întotdeauna cu o rezistență când puteți.
Următorii pași naturali ar putea fi adăugarea unui factor de coadă, estimarea incertitudinii rezervei (după metoda lui Mack) sau lăsarea REML să aleagă lamb automat în loc să-l aleagă cu ochii.
Ați depistat o eroare sau aveți o modalitate preferată de a netezi factorii de dezvoltare? Anunță-mă în comentarii!
