Greg Brockman, directorul OpenAI, a recunoscut că ChatGPT poate completa propoziții din articolele NYT text
Pe scurt: Pe lângă preocupările legate de dispariția umană sau de o bulă financiară masivă, una dintre cele mai mari controverse ale inteligenței artificiale generative este modul în care giganții tehnologiei își antrenează modelele. În timp ce OpenAI și Microsoft susțin că instruirea AI pe materiale protejate prin drepturi de autor intră sub incidența utilizării loiale, comentariile interne ale companiilor ar putea sugera altfel.
Brent Hecht, directorul de științe aplicate al Microsoft, a prezis că oamenii din întreaga lume vor vedea modelele lingvistice mari ca un furt la o scară fără precedent, potrivit documentelor instanței publicate joi. Comentariile par să contracareze apărarea publică a Microsoft și OpenAI împotriva unui proces în desfășurare introdus de instituțiile de știri.
În cel mai recent dosar al cazului, Hecht a spus că IA generativă ar putea fi cel mai mare furt de muncă din istoria umanității, în timp ce descrie modul în care Microsoft, OpenAI și alte companii de AI își antrenează modelele pe cantități masive de material de pe internetul deschis. Practica se află în centrul procesului pentru drepturi de autor pe care The New York Times l-a intentat la sfârșitul anului 2023.
Microsoft și OpenAI susțin că instruirea modelelor AI pe articole din NYT și din alte publicații se încadrează în utilizarea loială, similar cu un student care citește cărți. Pârâții susțin, de asemenea, că producția generativă de IA bazată pe acele articole transformă suficient materialul original.
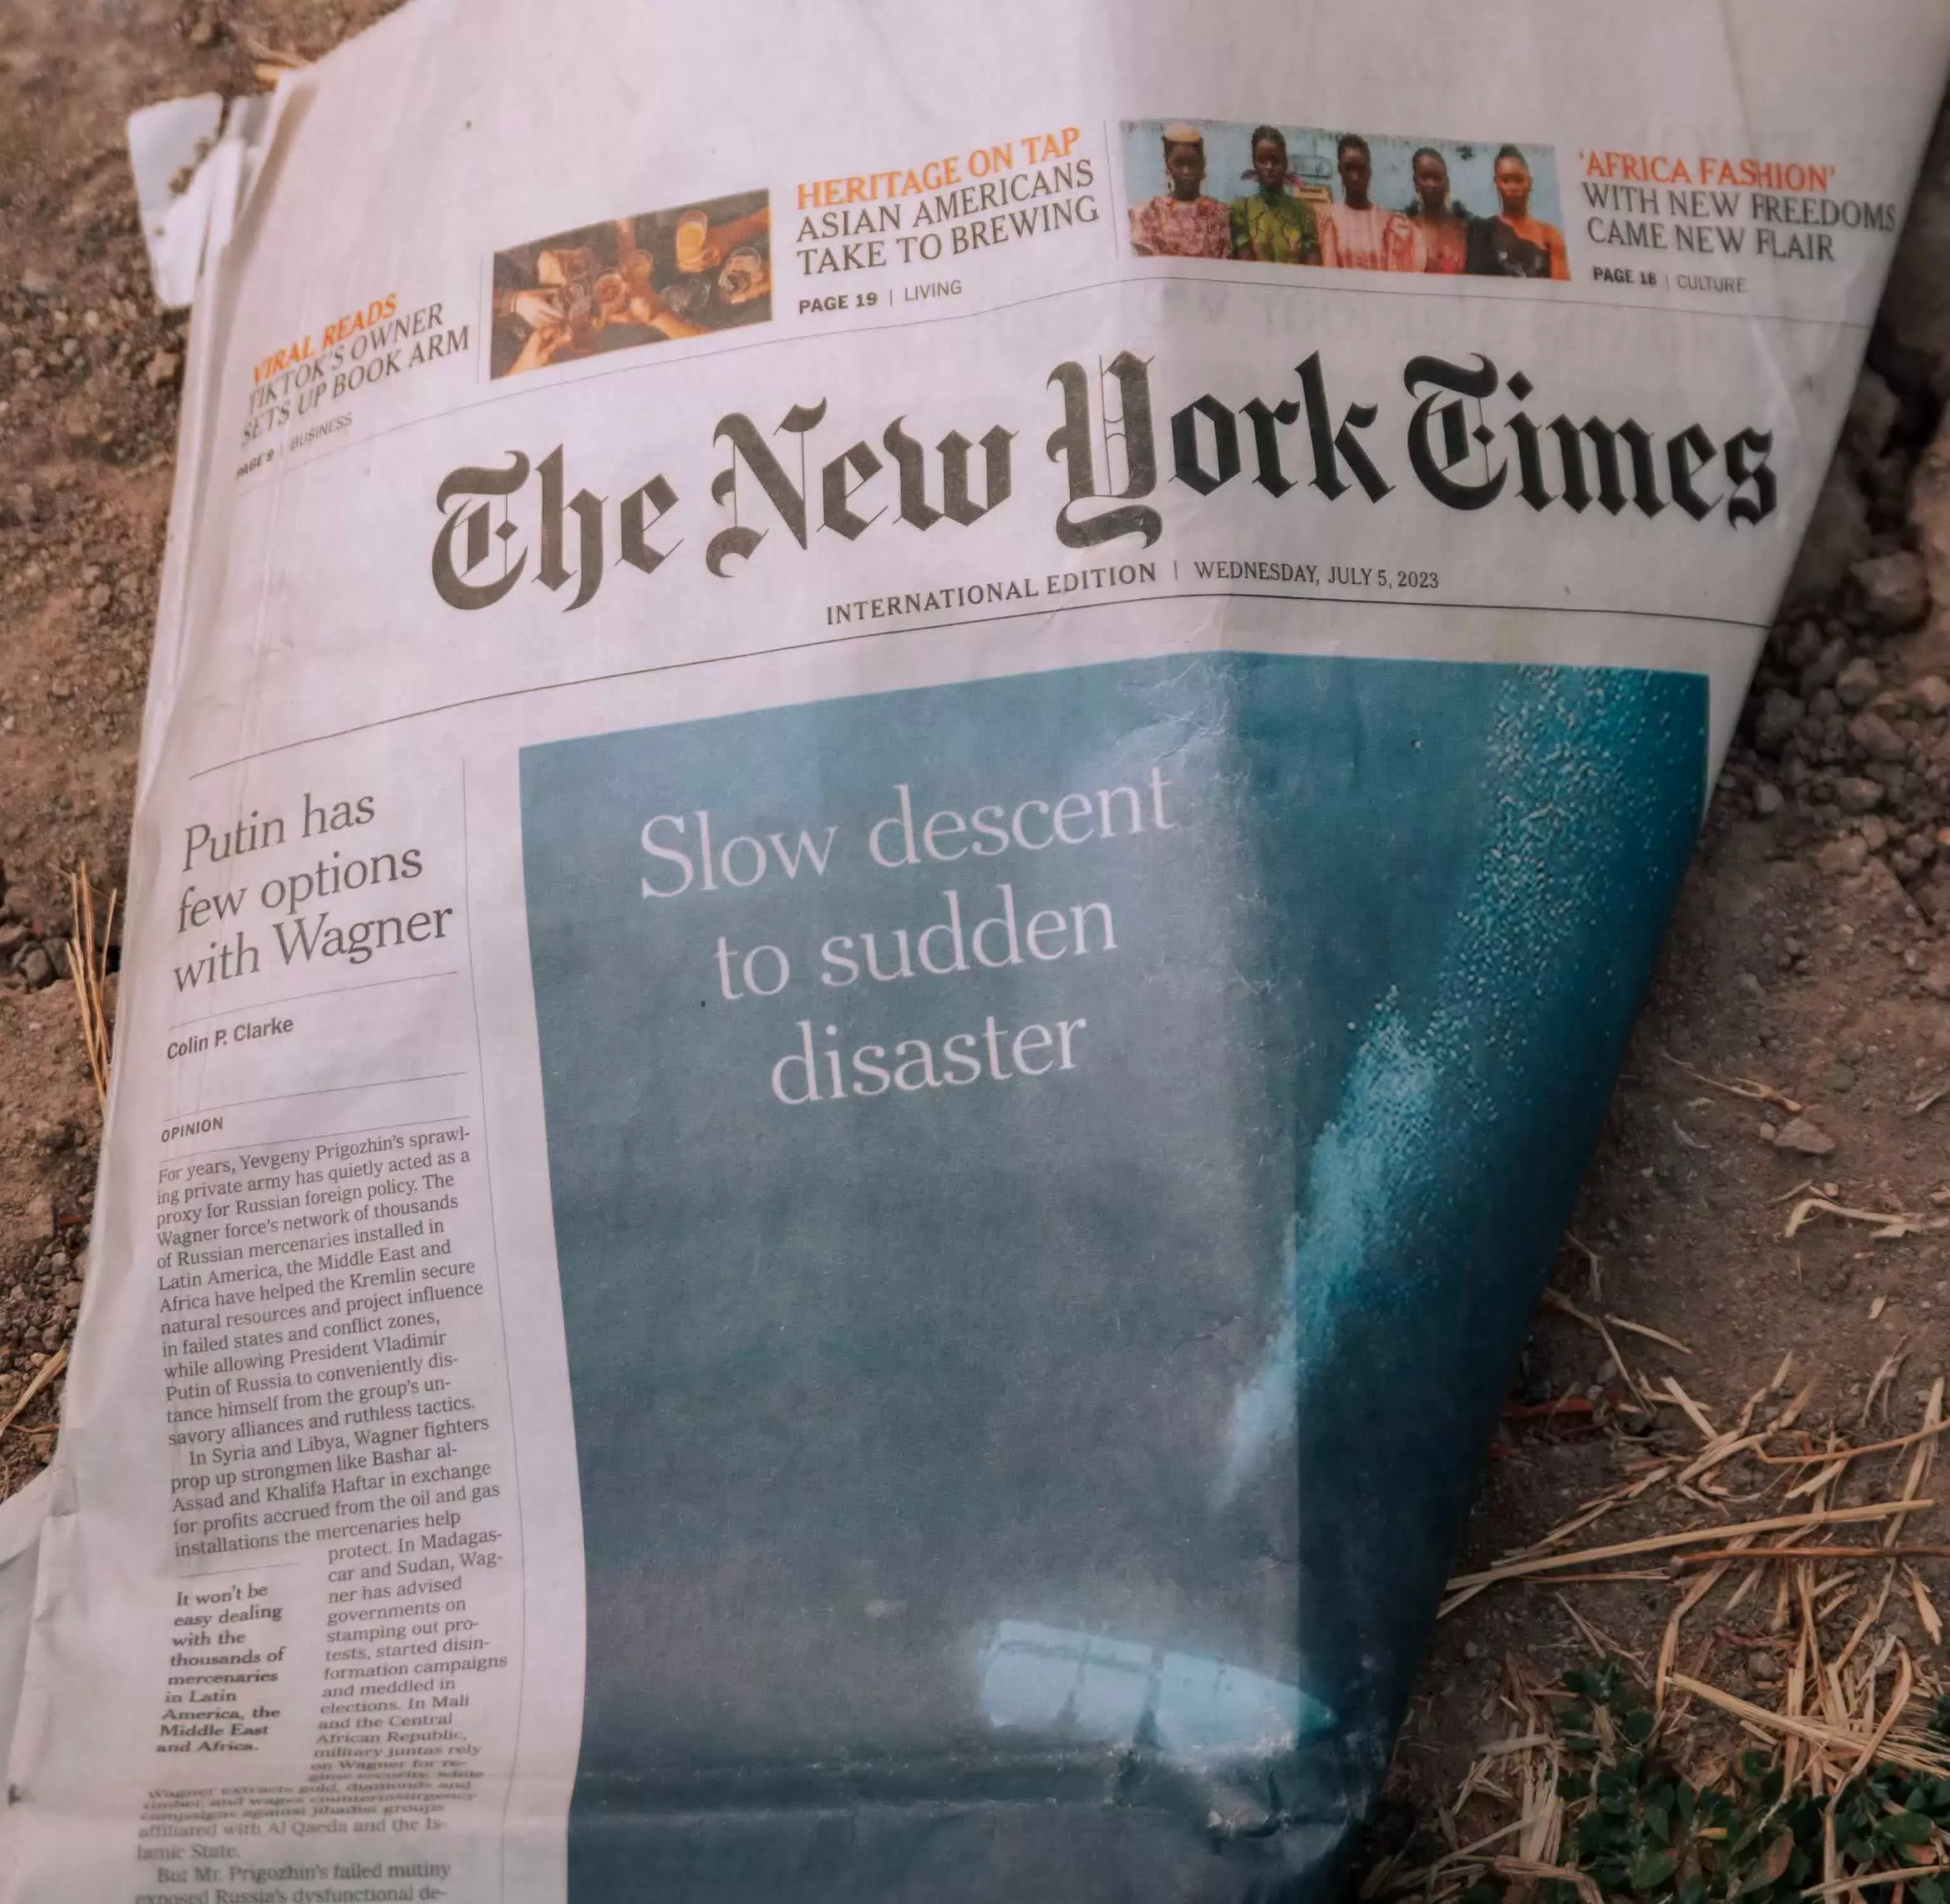
Cu toate acestea, dosarul de joi conține comentarii interne de la OpenAI care evidențiază capacitatea AI de a reproduce articole de știri. De exemplu, directorul OpenAI Greg Brockman a recunoscut că ChatGPT poate prezice și completa propoziții din articolele NYT atunci când lucrează cu materialul punctului de vânzare. Hecht a mai susținut că câștigarea procesului ar putea impune inculpaților „să bată joc complet de ideea de utilizare loială”.
OpenAI a recunoscut anterior că antrenarea AI fără accesarea materialului protejat prin drepturi de autor este imposibilă. Fostul director al Meta, Nick Clegg, a făcut ecou această opinie anul trecut, susținând că AI ar muri aproape imediat dacă legea drepturilor de autor ar fi aplicată împotriva ei.
Între timp, companiile AI au continuat să-și antreneze modelele pe o mulțime de date despre utilizatori, articole și alte materiale. Meta a atras controverse pentru antrenarea AI-ului său cu privire la comportamentul angajaților, GitHub Copilot de la Microsoft se antrenează cu privire la datele utilizatorilor, cu excepția cazului în care utilizatorii se renunță, iar Twitch a început să permită streamerilor să renunțe abia după instruirea materialelor lor de ani de zile. Dezvoltatorii AI cumpără, scanează și distrug în liniște milioane de cărți pentru a aduna mai mult material de instruire.
Impactul AI generativ asupra modelului de afaceri de știri este un alt pilon al procesului NYT. Google și alte motoare de căutare oferă acum rezumate generate de AI ale informațiilor din articole ca răspuns la întrebările utilizatorilor, descurajând potențial cititorii să viziteze site-urile de știri. În dosarul din această săptămână, un director OpenAI implicat în dezvoltarea ChatGPT a declarat că editorii se confruntă cu o amenințare existențială din partea AI.
