(Acest articol a fost publicat pentru prima dată pe Jason Bryerși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta problema legată de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
NOTĂ: Orice actualizări ale acestui articol vor fi menținute aici: https://medley.bryer.org/articles/stratified_glm.html
Introducere
Modelarea statistică atunci când există un dezechilibru substanțial în variabila dependentă ridică provocări unice. În aceste situații, modelele favorizează adesea clasa majoritară. Două abordări comune sunt supraeșantionarea și downsampling. Suprasantionarea este procesul de creștere a eșantionării grupului minoritar pentru a se potrivi mai strâns cu dimensiunea grupului majoritar. Dimpotrivă, subeșantionarea implică eșantionarea din grupul majoritar pentru a se potrivi mai strâns cu dimensiunea grupului minoritar. Acesta din urmă nu este, în general, preferat, deoarece crește artificial dimensiunea eșantionului (de ex n) rezultând în scăderea estimărilor de eroare standard.1 Această lucrare introduce o abordare în care modelele de regresie logistică multiple sunt estimate utilizând grupul minoritar și un subset unic al grupului majoritar, astfel încât toate observațiile să fie observații majoritare să fie utilizate într-un singur model, în timp ce grupul minoritar este reutilizat în toate modelele. Modelul final reunește modelele folosind Regulile lui Rubin definite în contextul imputării multiple (Rubin, 2004).
Impactul asupra valorilor adaptate
În Statele Unite, există în general două tipuri de școli, publice și private. Școlile publice sunt finanțate din impozite pe proprietate, în timp ce școlile private percep școlarizare pentru familii. Programul pentru evaluarea internațională a studenților (PISA) este o evaluare internațională gestionată de OCDE. Măsoară cât de bine elevii de 15 ani își aplică cunoștințele și abilitățile de rezolvare a problemelor în citire, matematică și știință la provocările din lumea reală. PISA eșantionează studenți din școli publice și private din Statele Unite. The medley pachetul conține un subset de date PISA pentru Statele Unite, care conține 5233 de observații a 44 de variabile. Există 4888 de elevi de școală publică și 345 de elevi de școală privată (6,5927766%)
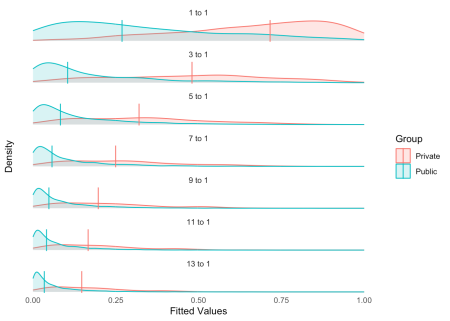
Pentru a exemplifica problema cu estimarea regresiei logistice cu date dezechilibrate, să luăm în considerare câteva modele în care raportul școlilor publice și private variază de la 1 la 1 la 14 la 1. Figura @ref(fig:shrinking-values) reprezintă distribuțiile valorilor ajustate dintr-o regresie logistică cu rapoarte variabile ale școlilor publice-private. Adică, toți elevii din școlile private au fost folosiți în fiecare model. Pentru modelul 1-la-1, primele 345 de observații din școala publică, apoi pentru modelul 2-la-1 primele 690 de observații, etc., până când modelul final utilizează toate observațiile. Liniile verticale corespund valorilor mediane ajustate. Cu toate celelalte egale, pe măsură ce raportul dintre școlile publice și private crește, gama de valori adaptate se micșorează spre grupul majoritar.2
Modelare stratificată
Scopul modelării stratificate este de a aborda dezechilibrul variabilei de rezultat, valorificând în același timp toate datele. Primul pas este separarea claselor majoritare de cele minoritare. Observațiile din clasa minoritară vor fi utilizate în toate estimările modelului. Observațiilor din clasa majoritară li se va atribui aleatoriu un model. Numărul de modele este determinat de amploarea dezechilibrului raportul specificat de observații majoritare la minoritate (valorul implicit este 1). Pentru datele PISA de aici, există de aproximativ 14 ori mai multe observații din școlile publice decât observații din școlile private. Folosind un raport de unu vom estima 14 modele. De menționat că elevii din școlile publice vor fi utilizați într-un singur model, în timp ce elevii din școlile private vor fi utilizați în toate modelele. The stratified_glm() realizează modelarea. Pentru a maximiza flexibilitatea, această funcție poate transmite orice parametru către stats::glm() funcţie. Cu toate acestea, parametrii care fac referire la observații specifice (de ex weights, subset) nu trebuie folosit deoarece stats::glm() va fi apelat cu subseturi de date care nu se vor potrivi cu ordinea datelor. În mod similar, cel family parametrul este implicit binomial(link='logit') deoarece această metodă funcționează numai cu probleme de clasificare cu două clase.
results <- medley::stratified_glm(
    formula = Private ~ .,
    data = pisa,
    ratio = 1
)
Rezultatele tuturor modelelor sunt combinate folosind mitools::MIcombine funcţie (Lumley, 2026). Deși această abordare este concepută pentru a combina mai multe seturi de date imputate, în acest caz ne permite să avem un singur coeficient și o eroare standard care nu este artificial mai mică, având în vedere o dimensiune mai mare a eșantionului pentru un model. Valorile ajustate de la toate modelele individuale sunt disponibile în fitted element al obiectului returnat. În plus, rezultatele modelului individual sunt disponibile în model element. The summary() funcția returnează un cadru de date cu coeficienții combinați, eroarea standard și valoarea p. Mai jos sunt imprimați doar coeficienții în care p < 0,1 pentru a economisi spațiu.
pisa_summary <- summary(results)
pisa_summary |> dplyr::filter(p < 0.1)
                     coefficients   se     p
(Intercept)                 -5.21 2.63 0.051
ST04Q01Male                  0.84 0.28 0.004
ST08Q04TRUE                 -0.50 0.27 0.071
ST08Q05TRUE                  0.75 0.36 0.038
ST20Q06TRUE                  1.79 0.95 0.060
ST20Q07TRUE                  0.72 0.31 0.021
ST21Q05Three or more         0.93 0.45 0.042
ST22Q01201-500 books         1.18 0.59 0.050
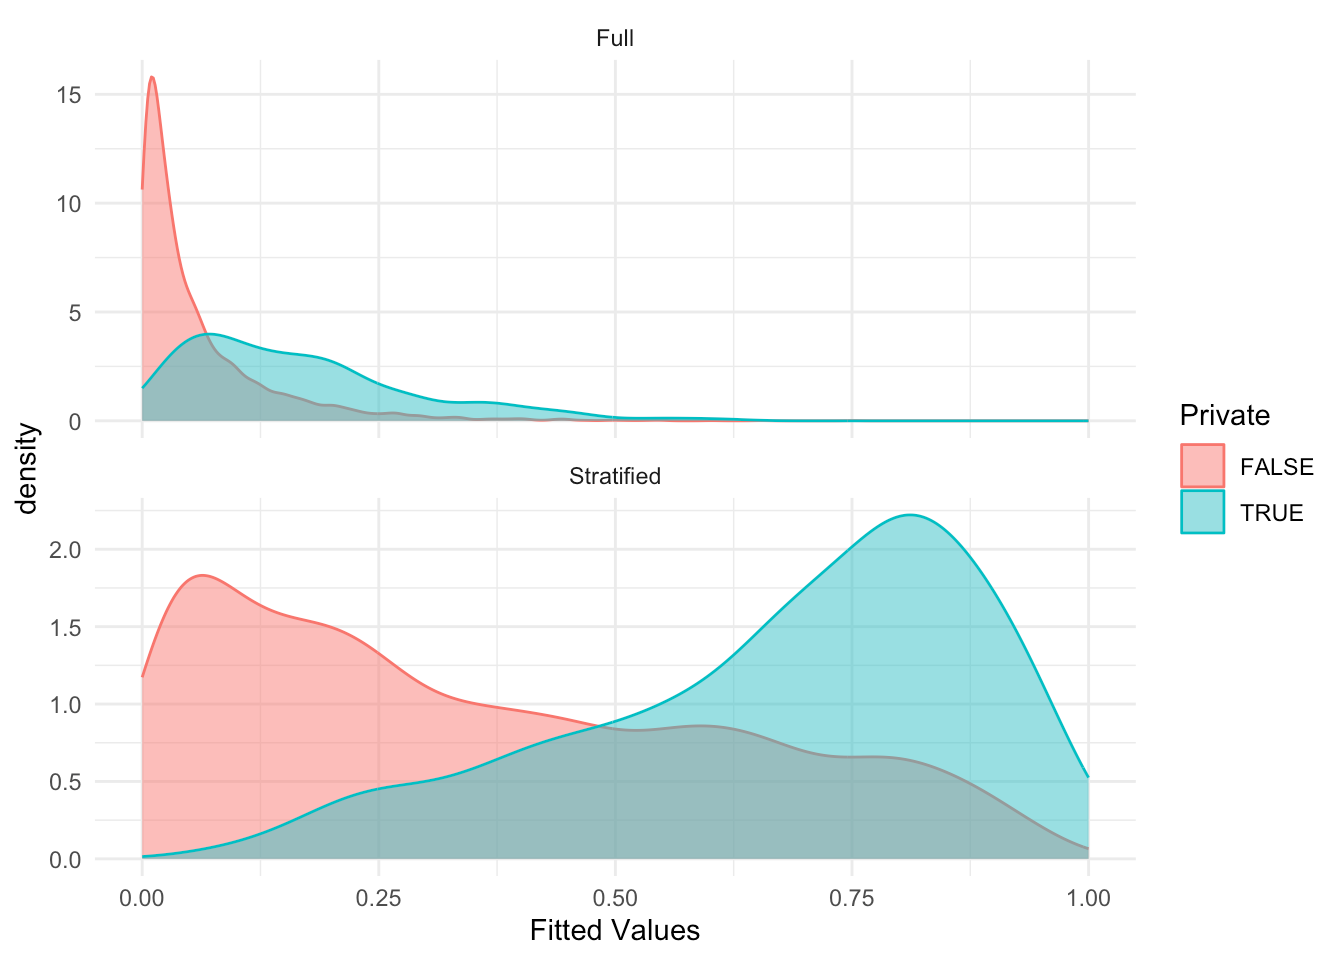
Figura @ref(fig:fitted-distributions) reprezintă grafic distribuțiile densității din modelul complet (model unic folosind toate datele) și modelele stratificate. Eșantionul stratificat arată o distribuție care se întinde pe întregul interval de valori ajustate, rezultând valori ajustate care sunt mai interpretabile.
plot(results)

Predicțiile pentru date noi pot fi estimate folosind predict() funcţie.
pisa_predicted <- predict(results, newdata = pisa)
head(pisa_predicted)
   1    2    3    4    5    6
0.79 0.16 0.30 0.24 0.22 0.46
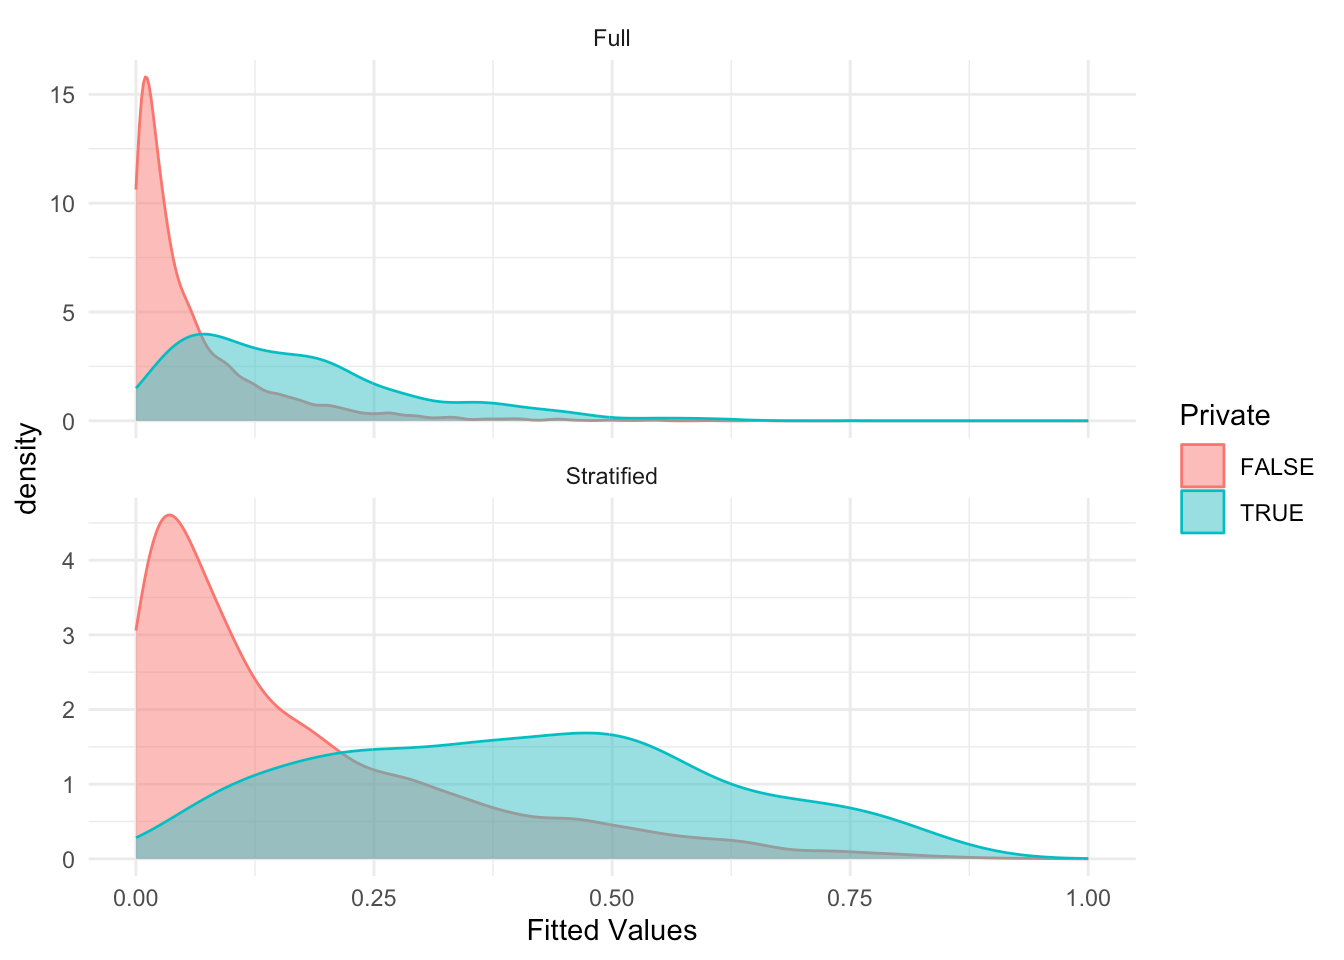
Figura @ref(fig:fitted-distributions-3) arată cum modelarea stratificată este mai puțin eficientă atunci când raportul dintre studenți publici și privați crește la 3-la-1.
medley::stratified_glm(
    formula = Private ~ .,
    data = pisa,
    ratio = 3
) |> plot()
Impactul pentru modelarea predictivă
Modelarea stratificată oferă în mod clar o strategie pentru abordarea problemei scăderii valorilor ajustate din regresia logistică, pe măsură ce dezechilibrul rezultatului crește. În această secțiune vom explora ce impact, dacă este cazul, are această abordare atunci când modelăm pentru predicție. Pentru început, ne vom împărți datele într-un set de date de instruire și validare cu 80% pentru instruire și 20% pentru validare.
set.seed(2112); split <- medley::stratified_split(pisa, 'Private', 0.8)
pisa_train <- split$train
pisa_valid <- split$validation
pisa_train$Private |> table() |> prop.table()
pisa_valid$Private |> table() |> prop.table()
Model complet
În primul rând, vom estima modelul de regresie logistică utilizând setul complet de date.
full_model <- glm(Private ~ ., data = pisa_train, family = binomial(link = 'logit'))
Obțineți predicțiile pentru setul de date de validare.
full_new_predictions <- predict(full_model, newdata = pisa_valid, type="response")
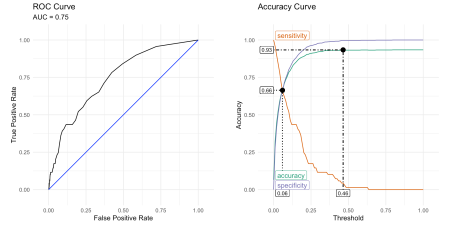
Calculăm valorile pentru o caracteristică de funcționare a receptorului mai jos. Funcția de rezumat ne oferă niște praguri care maximizează acuratețea, minimizează costurile3sau unde curbele de specificitate și sensibilitate se intersectează.
full_roc <- medley::calculate_roc(
    predictions = full_new_predictions,
    observed = pisa_valid$Private
)
summary(full_roc)
AUC = 0.747
Cost of false-positive = 1
Cost of false-negative = 1
Threshold with minimum cost = 0.465 (accuracy = 93.4%)
Threshold with maximum accuracy = 0.465 (accuracy = 93.4%)
Sensitivity and specificity intersection = 0.059 (accuracy = 66.4%)
Figura @ref(fig:full-roc) reprezintă graficul caracteristicilor de funcționare a receptorului pentru datele de validare folosind modelul complet.
plot(full_roc)
Pentru a echilibra sensibilitatea și specificitatea, oferim o matrice de confuzie folosind intersecția acestor două curbe ca punct de tăiere pentru determinarea clasei de rezultat.
medley::confusion_matrix(
    observed = pisa_valid$Private,
    predicted = full_new_predictions > attr(full_roc, 'intersection')
)
              predicted
  observed        FALSE         TRUE
     FALSE 649 (61.99%) 329 (31.42%)
      TRUE   23 (2.20%)   46 (4.39%)
Accuracy: 66.38%
Sensitivity: 66.36%
Specificity: 66.67%
Model stratificat
Acum să estimăm modelul stratificat.
stratified_model <- medley::stratified_glm(
    formula = Private ~ .,
    data = pisa_train,
    ratio = 1
)
stratified_new_predictions <- predict(stratified_model, newdata = pisa_valid)
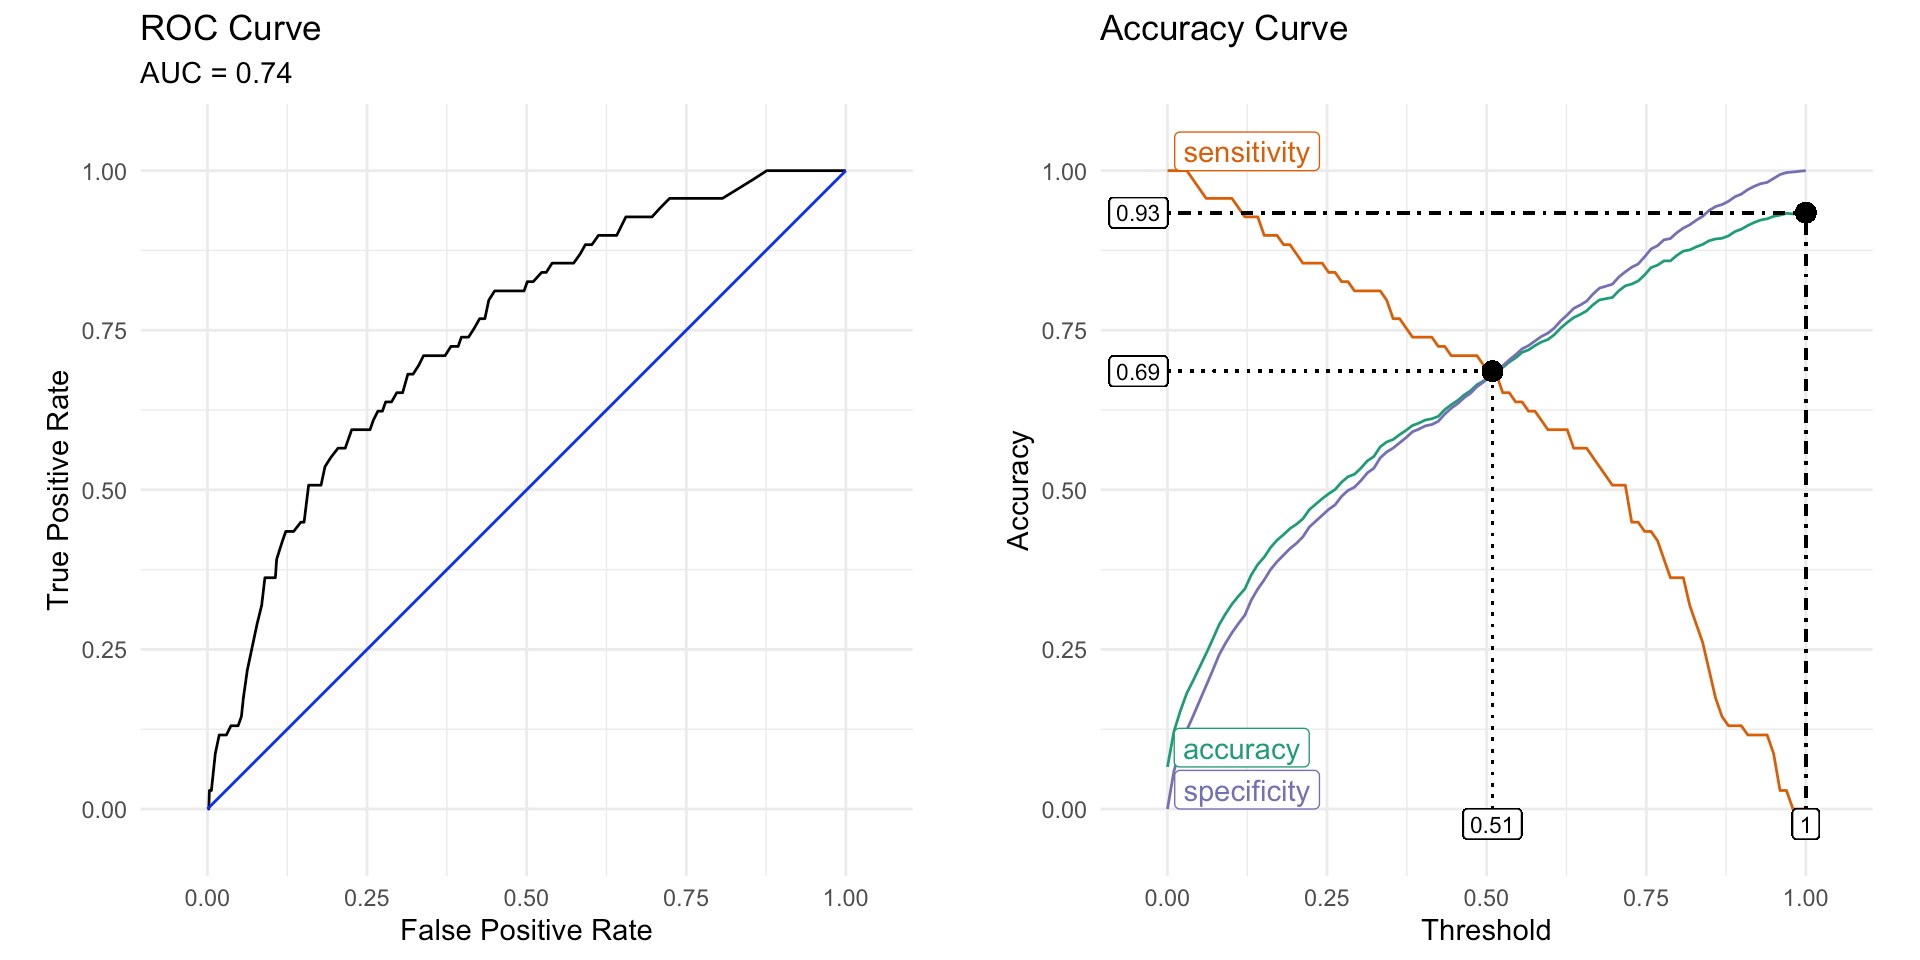
Examinați caracteristicile de funcționare a receptorului pentru a determina punctul optim de tăiere. Figura @ref(fig:stratified-roc) prezintă rezultatele.
stratified_roc <- medley::calculate_roc(
    predictions = stratified_new_predictions,
    observed = pisa_valid$Private
)
summary(stratified_roc)
AUC = 0.745
Cost of false-positive = 1
Cost of false-negative = 1
Threshold with minimum cost = 1 (accuracy = 93.4%)
Threshold with maximum accuracy = 1 (accuracy = 93.4%)
Sensitivity and specificity intersection = 0.509 (accuracy = 68.6%)
plot(stratified_roc)
În cele din urmă, calculați matricea de confuzie folosind intersecția curbelor de sensibilitate și specificitate ca punct de tăiere pentru determinarea clasei prezise.
medley::confusion_matrix(
    observed = pisa_valid$Private,
    predicted = full_new_predictions > attr(stratified_roc, 'intersection')
)
              predicted
  observed        FALSE      TRUE
     FALSE 975 (93.12%) 3 (0.29%)
      TRUE   68 (6.49%) 1 (0.10%)
Accuracy: 93.22%
Sensitivity: 99.69%
Specificity: 1.45%
Adesea, textele introductive pentru modelarea predictivă și regresia logistică sugerează utilizarea unui punct de tăiere de 0,5 pentru determinarea clasei. După cum se arată mai sus, acesta nu este punctul de tăiere optim atunci când există un dezechilibru semnificativ. Abordarea de modelare stratificată introdusă ne aduce mai aproape de acel punct de tăiere intuitiv din mijloc. Trebuie remarcat faptul că această abordare nu este mai bună sau mai proastă pentru a face predicții. Cu toate acestea, abordează problema micșorării valorilor ajustate și face ca valorile ajustate și prezise să fie mai interpretabile.
Concluzie
Abordarea de modelare stratificată oferă o abordare de modelare pentru regresia logistică în care interpretabilitatea valorilor ajustate sau prezise este semnificativă. Pentru modelarea predictivă, ajustarea punctului de tăiere pentru a face o predicție de clasă va oferi un rezultat similar. Cu toate acestea, această problemă a fost întâlnită inițial la efectuarea analizei scorului de înclinație (PSA). Regresia logistică este adesea folosită pentru a estima scorurile de înclinație, care sunt definite ca probabilitatea condiționată de a fi în tratament (Rosenbaum & Rubin, 1983). Când se utilizează regresia logistică, scorurile de propensiune sunt pur și simplu valorile ajustate din model. În acest context, având valori adaptate care acoperă întregul interval în care distribuția grupului de tratament (școli private în acest exemplu) este denaturată la dreapta și grupul de control (școli publice în acest exemplu) este denaturată la stânga. Pentru aceste situații, abordarea de modelare stratificată poate oferi o abordare rezonabilă pentru abordarea problemei scăderii valorilor ajustate din regresia logistică cu dezechilibru semnificativ.
