(Acest articol a fost publicat pentru prima dată pe R pe Statistici și Rși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta probleme legate de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
Notă: Această postare a fost scrisă în colaborare cu echipa Easy Stat Calc.
Majoritatea cititorilor învață că o medie generală este „doar media”. Problema începe când datele vin în subgrupuri. O rată globală nu este media simplă a ratelor subgrupului. Este o medie ponderată dintre ele, iar ponderile sunt mărimile subgrupurilor. Schimbați ponderile și răspunsul se schimbă, uneori suficient pentru a inversa o comparație.
Această inversare este cunoscută sub numele de paradoxul lui Simpson. Ilustrația clasică este datele privind admiterea absolvenților din 1973 de la Universitatea din California, Berkeley (Bickel și colab. 1975)care sunt livrate cu R ca UCBAdmissions. Acest articol nu se oprește la tabelul familiar „femeile se descurcă mai bine în cadrul departamentelor”. Pune trei întrebări pe care tabelul le lasă deschis:
- De cât depinde rezultatul reponderat care se amestecă solicitantul alegem ca referință?
- Exact în ce moment un mic avantaj în interiorul fiecărui subgrup este anulat de diferențele în amestecul de subgrup și cât de des un eșantion de o anumită dimensiune arată răsturnarea în apropierea aceluia punct?
- Când este rata generală numărul potrivit și când rata subgrupului este numărul potrivit?
Totul de mai jos folosește baza R, cu excepția complotului, care este realizat cu {ggplot2} pachet. O sămânță este setată la începutul codului de simulare pentru a asigura reproductibilitatea.
UCBAdmissions este un tabel 2 x 2 x 6: statutul de admitere, sexul și departamentul (cele mai mari șase departamente, etichetate de la A la F). Separăm numărul admis de totaluri și calculăm ratele la nivel de departament.
adm <- UCBAdmissions("Admitted", , ) # admitted, by gender x department
tot <- apply(UCBAdmissions, c(2, 3), sum) # all applicants, by gender x department
rate <- adm / tot # admission rate, by gender x department

overall <- rowSums(adm) / rowSums(tot)
round(100 * overall, 1)
##   Male Female
##   44.5   30.4
În aceste șase departamente, bărbații au fost admiși la 44,5% și femeile la 30,4%. Acum uită-te în interiorul fiecărui departament.
round(100 * rate, 1)
##         Dept
## Gender      A    B    C    D    E    F
##   Male   62.1 63.0 36.9 33.1 27.7  5.9
##   Female 82.4 68.0 34.1 34.9 23.9  7.0
tot
##         Dept
## Gender     A   B   C   D   E   F
##   Male   825 560 325 417 191 373
##   Female 108  25 593 375 393 341
Femeile au cea mai mare rată de admitere în patru din cele șase departamente (A, B, D și F). Bărbații conduc în C și E, cu marje mici. Cu toate acestea, rata generală pentru femei este cu 14 puncte mai mică. Explicația este în numărul de solicitanți: 825 din cei 933 de solicitanți la departamentul A erau bărbați, iar departamentul A admite mulți solicitanți, în timp ce majoritatea femeilor au aplicat la departamentele C la F, unde admiterea este mult mai grea.
round(100 * prop.table(tot, 1)(, "A"), 1) # share of each gender's applicants who applied to A
##   Male Female
##   30.7    5.9
Aproximativ 31% dintre bărbați au aplicat la departamentul A, față de 6% dintre femei.
Dacă departamentul i are rata de admitere (r_i) și o cotă (w_i) dintre solicitanți, rata totală este
(text{total} = sum_i w_i , r_i .)
În R aceasta este weighted.mean(rate, weights). Cu fiecare gen proprii solicitantul contează ca ponderi, reproduce exact ratele generale (pentru o verificare rapidă în afara lui R, cititorii pot folosi și un calculator mediu ponderat).
round(100 * c(
  Men = weighted.mean(rate("Male", ), tot("Male", )),
  Women = weighted.mean(rate("Female", ), tot("Female", ))
), 1)
##   Men Women
##  44.5  30.4
Întrebarea este ce se întâmplă când ambele genuri sunt ponderate de aceleaşi amestecați, astfel încât să comparăm ca și cum ar fi.
Nu există un „același amestec” corect. Putem folosi mixul pentru bărbați, mixul pentru femei, mixul combinat sau greutăți egale. Fiecare oferă un răspuns diferit, așa că merită să le arăți pe toate, mai degrabă decât o cifră reponderată.
wm <- function(w) {
  c(
    Men = weighted.mean(rate("Male", ), w),
    Women = weighted.mean(rate("Female", ), w)
  )
}

mixes <- rbind(
  "Own mix (observed)" = c(
    weighted.mean(rate("Male", ), tot("Male", )),
    weighted.mean(rate("Female", ), tot("Female", ))
  ),
  "Men's mix" = wm(tot("Male", )),
  "Women's mix" = wm(tot("Female", )),
  "Combined mix" = wm(colSums(tot)),
  "Equal weights" = wm(rep(1, 6))
)
colnames(mixes) <- c("Men", "Women")

data.frame(round(100 * mixes, 1),
  Gap = round(100 * (mixes(, "Women") - mixes(, "Men")), 1)
)
##                     Men Women   Gap
## Own mix (observed) 44.5  30.4 -14.2
## Men's mix          44.5  51.6   7.1
## Women's mix        30.2  30.4   0.1
## Combined mix       38.7  43.0   4.3
## Equal weights      38.1  41.7   3.6
Decalajul (femei minus bărbați, în puncte procentuale) se mută de la -14,2 cu mixurile observate la +4,3 cu mixul combinat, +3,6 cu ponderi egale, +7,1 cu mixul masculin și aproape nimic (+0,1) cu mixul feminin. S-au schimbat doar ponderile, niciodată ratele departamentului.
Cele mai multe provin dintr-un singur departament. Departamentul A are de departe cel mai mare decalaj în favoarea femeilor (82,4% față de 62,1%, aproximativ 20 de puncte, față de 5 puncte sau mai puțin în altă parte) și deține 21% din toți solicitanții. Sub mixul combinat contribuie cu 4,2 din cele 4,3 puncte. Ponderea lui explică și diferența dintre mixuri: 31% dintre candidații bărbați au mers la departamentul A, dar doar 6% dintre cei feminini. Lăsați deoparte și reponderați celelalte cinci departamente după amestecul lor combinat:
w5 <- colSums(tot)(2:6)
round(100 * c(
  Men = weighted.mean(rate("Male", 2:6), w5),
  Women = weighted.mean(rate("Female", 2:6), w5)
), 1)
##   Men Women
##  32.7  32.8
Fără departamentul A ambele rate sunt de aproximativ 33% (32,7% și 32,8%). Deci, titlul „femeile conduc” sub mixurile combinate și bărbați este în mare măsură un rezultat al departamentului A, iar un cititor care vede o singură cifră reponderată nu ar ști asta.
Datele Berkeley sunt un singur tabel. Pentru a studia mecanismul construim un model mic cu două grupuri de solicitanți, A și B (ca cele două genuri de mai sus) și două departamente, unul ușor și unul greu:
| Rata de admitere la grupa A | 72% | 22% |
| Rata de admitere la grupa B | 70% | 20% |
Grupa A învinge grupa B cu 2 puncte în ambele departamente. Rata totală a unui grup este
(begin{gathered} text{overall} = text{easy rate} – g times {} \ (text{share se aplică la departamentul hard}), end{gathered})
unde (g) este diferența dintre ratele departamentului ușor și cel greu (aici 0,50 pentru ambele grupuri). Scris (p_A) şi (p_B) pentru cotele solicitanților din grupa A și grupa B care se adresează la departamentul hard, grupa A este în urmă în general exact când
(0,02 < g times (p_A - p_B) quadLongleftrightarrowquad p_A - p_B > frac{0,02}{g}.)
Deci punctul de răsturnare depinde doar de două lucruri: mărimea avantajului în interiorul departamentelor (0,02) și decalajul dintre ratele de admitere ale departamentelor ((g)). Aici este 0,02 / 0,50 = 0,04. Dacă grupul B trimite 10% dintre solicitanții săi la departamentul hard, grupul A este în urmă în general odată ce mai mult de 14% dintre solicitanții lui A merg acolo.
easy <- c(A = 0.72, B = 0.70)
hard <- c(A = 0.22, B = 0.20)
pB <- 0.10 # share of group B applying to the hard department
gap <- unname(easy("A") - hard("A")) # 0.50 (same for both groups)
threshold <- 0.02 / gap
c(threshold = threshold, flip_when_pA_above = pB + threshold)
##          threshold flip_when_pA_above
##               0.04               0.14
Formula oferă punctul de răsturnare pentru adevărat ratele. Nu ne spune cât de des a eşantion de o dimensiune dată arată flip-ul în apropierea punctului respectiv. Această probabilitate poate fi calculată exact din distribuții binomiale, dar o simulare o arată mai simplu: trageți câți solicitanți din fiecare grup aleg departamentul greu, apoi trageți admiterea și înregistrați cât de des rata generală observată a lui A este sub cea a lui B.
set.seed(2026) # for reproducible results

sim_flip <- function(n, delta, reps = 10000) {
  pA <- pB + delta
  hA <- rbinom(reps, n, pA) # group A applicants to the hard department
  hB <- rbinom(reps, n, pB)
  aA <- rbinom(reps, hA, hard("A")) + rbinom(reps, n - hA, easy("A")) # admitted from A
  aB <- rbinom(reps, hB, hard("B")) + rbinom(reps, n - hB, easy("B"))
  mean(aA < aB) # share of samples where A is below B
}

deltas <- c(0, 0.02, 0.04, 0.06, 0.08, 0.12) # p_A - p_B
ns <- c(100, 400, 1600) # applicants per group

res <- sapply(ns, function(n) sapply(deltas, function(dl) sim_flip(n, dl)))
dimnames(res) <- list(paste0("delta=", deltas), paste0("n=", ns))
round(res, 3)
##            n=100 n=400 n=1600
## delta=0    0.351 0.266  0.110
## delta=0.02 0.412 0.370  0.270
## delta=0.04 0.470 0.489  0.487
## delta=0.06 0.533 0.600  0.717
## delta=0.08 0.595 0.703  0.877
## delta=0.12 0.699 0.873  0.990
library(ggplot2)

res_long <- data.frame(
  delta = rep(deltas, times = ncol(res)),
  n     = factor(rep(colnames(res), each = nrow(res)), levels = colnames(res)),
  share = as.vector(res)
)

ggplot(res_long, aes(x = delta, y = share, colour = n, shape = n)) +
  geom_vline(xintercept = threshold, linetype = "dashed", colour = "grey40") +
  annotate("text",
    x = threshold, y = 1, label = "threshold",
    hjust = -0.1, colour = "grey40"
  ) +
  geom_line(linewidth = 0.8) +
  geom_point(size = 2.5) +
  geom_text(
    data = subset(res_long, delta == max(delta)), aes(label = n),
    hjust = -0.3, size = 3.5, colour = "grey20", show.legend = FALSE
  ) +
  scale_colour_manual(values = c("#6da7ec", "#2a78d6", "#104281")) +
  scale_x_continuous(breaks = deltas, expand = expansion(mult = c(0.05, 0.2))) +
  ylim(0, 1) +
  labs(
    x = "Difference in share applying to the hard department",
    y = "Share of samples where A is below B",
    colour = "Applicants per group", shape = "Applicants per group"
  ) +
  theme_minimal() +
  theme(legend.position = "top", panel.grid.minor = element_blank())

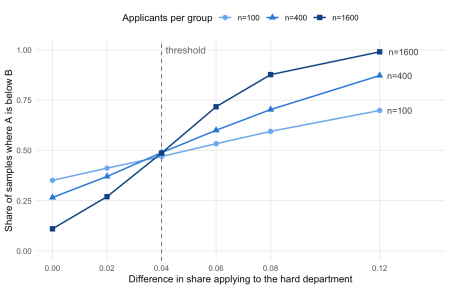
Trei lucruri arată simularea:
- La prag, rezultatul este o monedă pentru fiecare dimensiune a eșantionului. La o diferență de 0,04, A este sub B în aproximativ 47% până la 49% din probe, indiferent dacă n este 100, 400 sau 1.600. Ponderea este puțin sub 50%, deoarece eșantioanele în care A și B admit exact același număr nu sunt socotite ca un flip.
- Sub prag, mostrele mici greșesc adesea. Cu amestecuri identice (diferența 0), grupul A este cu adevărat mai bun în ambele departamente, dar cu 100 de solicitanți per grup, A este sub B în 35% dintre eșantioane. Cu 1.600 scade la 11%.
- Deasupra pragului, mostrele mai mari fac ca flip-ul să fie aproape sigur. La o diferență de 0,12 flip-ul arată în 70% din probe cu n = 100 și în 99% cu n = 1.600.
Deci, un eșantion mai mare accentuează de orice parte a pragului se află amestecul adevărat. Nu mișcă pragul în sine.
Statisticile nu aleg între nivelul de departament și rata generală. Întrebarea face.
- Tarifele departamentului descrieți modul în care fiecare departament tratează solicitanții pe care îi primește. Ele sunt numerele naturale dacă întrebarea este dacă deciziile de admitere ale unui departament favorizează un singur gen.
- Rata totală reflectă, de asemenea, locul în care oamenii aleg să aplice. Este numărul firesc dacă întrebarea este ce cotă din solicitanții fiecărui gen au ajuns să fie admiși, indiferent de motivul diferenței.
Numai datele din Berkeley nu pot stabili dacă a existat discriminare. Datele sunt pentru un ciclu de admitere, șase departamente și două sexe înregistrate. Tarifele departamentelor nu arată niciun avantaj sistematic pentru bărbați. Ele nu arată de ce femeile au aplicat la departamentele mai grele în număr mai mare sau dacă lucrurile care se întâmplă înainte de o cerere (consiliere, finanțare, oportunități anterioare) au jucat un rol. Acestea sunt întrebări cauzale, iar răspunsul la ele necesită presupuneri și informații dincolo de un tabel de numărări.
Obiceiul practic care decurge din aceasta este simplu. Când vedeți o rată globală pentru un grup, întrebați ce ponderi au produs-o, spuneți ce amestec de referință ați folosit pentru orice comparație și arătați cum se schimbă rezultatul atunci când amestecul se schimbă.
Multumesc pentru lectura.
Ca întotdeauna, dacă aveți o întrebare sau o sugestie legată de subiectul tratat în acest articol, vă rugăm să o adăugați ca comentariu pentru ca alți cititori să poată beneficia de discuție.
