Ce este PLAMo 3 Translate?
PLAMo 3 Translate este o familie de modele de limbi mari dezvoltate de Preferred Networks (PFN) special pentru traducere. Articolul tehnic al PFN din 5 noiembrie 2026, PLAMo 3 Translate: Traducere de clasă mondială cu greutăți deschise – Iată cum am construit-oexplică procesul de dezvoltare și lansarea greutăților de model descărcabile.
PFN antrenează modelele pe perechi sursă-traducere și le rafinează în continuare pentru a prefera traduceri mai bune. Modelele mai mici învață și de la modelul 31B prin distilare. Familia acceptă 53 de limbi și poate lua în considerare contextul înconjurător și un glosar. Aceste caracteristici se potrivesc fluxului nostru de lucru pentru lecție: putem furniza explicații din apropiere și terminologie tehnică preferată atunci când traducem un pasaj.
Modelele vin în patru dimensiuni: parametri 0.8B, 2B, 8B și 31B. Fluxul nostru de lucru folosește pfnet/plamo-3-translate-8b-MLX-4bitmodelul 8B într-un format MLX de 4 biți care reduce utilizarea memoriei pentru generarea locală pe Mac-urile Apple silicon. Greutățile modelului sunt distribuite sub licența comunitară PLAMo.
Explorați cele cinci ediții lingvistice
Lecția introductivă acoperă organizarea datelor în foi de calcul, folosind R și RStudio, manipularea datelor cu ajutorul dplyrși vizualizarea datelor. Fiecare ediție lingvistică are un site web de lecție pentru cursanți și un depozit pentru colaboratori:
Proiectul nostru Crowdin a primit și contribuții de traducere în portugheză și sunt recunoscător tuturor celor care au contribuit cu ele. Îmi pare rău că portugheza nu este inclusă printre aceste ediții: modelul de traducere PLAMo pe care îl folosim în prezent nu acceptă portugheza, care este absentă din lista sa de limbi acceptate.
Acoperirea traducerilor și revizuirea sunt încă în curs. Unele pagini de configurare și etichetele interfeței rămân în limba engleză. La momentul redactării acestui articol, episoadele publicate în urdu sunt disponibile, dar ghidul de configurare și traducere al actualizatorului acelui depozit se referă în continuare la japoneză și necesită adaptare înainte de a fi folosit pentru a regenera textul urdu.
Cum funcționează sistemul de traducere
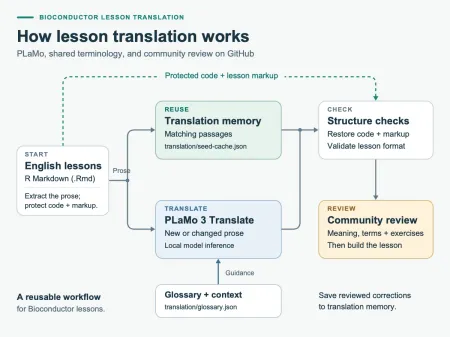
Figura 1: pasajele care se potrivesc reutilizează memoria de traducere; proza nouă sau schimbată este tradusă cu PLAMo. Codul protejat și marcajul se reunesc textului înainte de verificări structurale, revizuire a comunității și construirea unei lecții.
- Citiți o revizuire a sursei în limba engleză. Traducătorul citește fișierele R Markdown ale lecției din amonte dintr-o revizuire Git fără a le verifica peste fișierele de lucru traduse.
- Reutilizați traducerile potrivite. Fiecare depozit de traduceri stochează memoria de traducere versiunea sa în
translation/seed-cache.json. Acest fișier JSON stochează traducerile anterioare și stările de revizuire în funcție de pasaj sursă și episod. Înregistrările care se potrivesc pot fi reutilizate, în timp ce proza nouă sau modificată este trimisă la model. - Ghidează terminologia și protejează structura. Un glosar specific limbii și un ghid contextual ajută la dezambiguizarea termenilor. Blocurile de cod, codul inline, destinațiile linkurilor și marcarea lecției sunt protejate în timpul traducerii, iar verificările structurale sunt executate înainte ca fișierele de lecție să fie înlocuite.
- Revizuiește și construiește. Managerii inspectează textul tradus și modificările de memorie, construiesc lecția și commit rezultatul revizuit. Traducatorul însuși nu comite și nu împinge modificări.
Actualizați singur o traducere
Pentru a actualiza singur o traducere, urmați translation/README.md în depozitul pentru limba dvs. Aceste documente acoperă configurarea mediului, preluarea sursei în limba engleză, previzualizarea modificărilor, generarea de traduceri, revizuirea rezultatelor și construirea lecției:
Pentru urdu, se aplică în continuare configurația actualizatorului și avertismentul de documentare de mai sus.
De exemplu, în depozitul japonez, după configurarea telecomenzii din amonte, așa cum este descris în ghidul său, un întreținător poate rula:
git fetch upstream main
uv run --locked scripts/translate.py --source-ref upstream/main --dry-run
uv run --locked scripts/translate.py --source-ref upstream/main --update-memory
git diff -- episodes translation
Rscript scripts/build.R
Funcția uscată arată ce pasaje pot fi refolosite și care necesită traducere, fără a genera text nou sau a scrie fișiere de lecție. The --update-memory opțiunea salvează noi înregistrări de traducere în translation/seed-cache.json și proveniența sursei la translation/source-manifest.json pentru revizuire. Cache-ul de rulare local sub .cache/translation/ este ignorat de Git. Alte ediții pot folosi un alt nume de la distanță, așa că urmați translation/README.md în depozitul pe care îl actualizați.
De asemenea, traducătorul verifică modificările locale și se oprește înainte de a suprascrie o lecție editată. Adaptările mici ale construcției sunt înregistrate separat, cu verificări față de sursa așteptată. Imaginile, seturile de date și comandarea episoadelor necesită în continuare întreținere separată atunci când lecția de engleză se schimbă.
Ajutați să faceți lecțiile mai bune
O construcție reușită arată că lecția poate fi redată, dar cititorii și instructorii trebuie să verifice semnificația acesteia. O traducere poate suna fluent în timp ce se schimbă o condiție de exercițiu, se folosește un termen tehnic necunoscut sau se pierde o distincție importantă. Traducerea/README.md din depozitul de traduceri simplificate din chineză identifică în mod explicit memoria de traducere inițială ca fiind generată de mașini și care necesită revizuire.
Dacă utilizați una dintre aceste limbi, vă rugăm să încercați un episod și să îl comparați cu lecția de engleză. Ajutăm în mod special cu:
- Limbă și terminologie: sugerați explicații mai clare și vocabular familiar comunității dvs. locale de cercetare.
- Exerciții și predare: verificați dacă întrebările, soluțiile și notele instructorului păstrează obiectivele originale de învățare.
- Corecții care continuă: ajutați menținătorii să actualizeze glosarul, ghidul de context și memoria de traducere alături de textul lecției.
Deschideți o problemă în depozitul relevant cu numele episodului, pasajul la care vă referiți și o corectare sau o explicație sugerată. Cererile de tragere sunt de asemenea binevenite; vă rugăm să urmați contribuția și ghidurile de traducere ale depozitului respectiv. Dacă sunteți interesat să revizuiți traducerile, să adăugați suport pentru o altă limbă sau să traduceți o altă lecție, alăturați-vă discuției în canalul #documentation-translation din chatul comunității Bioconductor.
Mulțumim autorilor și întreținătorilor lecțiilor originale și tuturor celor care traduc, revizuiesc și predau aceste materiale. Această lucrare se bazează pe eforturile de traducere ale comunității descrise în raportul atelierului japonez și este susținută de Programul Campionilor pentru Dezvoltatori Bioconductor.
