(Acest articol a fost publicat pentru prima dată pe Blogul Academiei Rsquaredși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta problema legată de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
blorr 0.3.2 este pe CRAN. blorr oferă instrumente pentru regresia logistică binară în R: statistici de potrivire a modelului, selecția variabilelor, analiză bivariată, ponderea dovezilor și diagramele de validare utilizate în scoringul creditului (tabelul câștigurilor, curba ROC, graficul KS și curba Lorenz), toate construite în jurul valorii de glm() obiecte.
Ultima postare blorr a acoperit 0.2.0 în 2019. De atunci au existat patru versiuni CRAN (0.2.1, 0.2.2, 0.3.0 și 0.3.1), iar aceasta modifică numerele care ar putea fi deja în rapoarte:
- Valorile Pseudo-R² și indicele Gini folosesc acum rândurile pe care modelul a fost montat efectiv, iar indicele Gini urmează definiția punctajului creditului

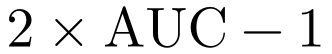 .
- Testul raportului de probabilitate folosește diferența de grade reziduale de libertate, astfel încât predictorii factorilor au dreptate
 -valoare.
- Tabelele de câștiguri, matricele de confuzie și ratele de segmentare au fost reconstruite în jurul răspunsului adaptat.
Dacă raportați indicele Gini, Cox–Snell sau Nagelkerke R² sau un test al raportului de probabilitate de la blorr, citiți următoarele trei secțiuni înainte de a reutiliza acele numere. Toți ceilalți pot începe la Ce este nou din 2019.
Îl puteți instala din CRAN cu:
Cod
install.packages("blorr")
Puteți vedea o listă completă a modificărilor în notele de lansare.
Aceste remedieri modifică rezultatele. În fiecare caz, noua valoare este de acord cu definiția sau cu baza R, deci noua valoare este cea de raportat.
Cum am verificat: Fiecare număr din această postare a fost reluat împotriva blorr 0.3.2 de la CRAN; versiunea a trecut prin audituri independente înainte de depunere.
Valorile pseudo-R² folosesc rândurile montate de model?
Cox–Snell și Nagelkerke R² sunt funcții ale log-probabilităților ajustate și numai de interceptare și ale numărului de observații. Dacă datele conțin valori lipsă, acel număr este rândurile folosite de model, nu rândurile din cadrul de date.
bank_marketing înregistrează rezultatele de marketing ale depozitului la termen bancar. Nu are valori lipsă, așa că ștergem 300 de solduri pentru a imita înregistrările incomplete:
Cod
bank_incomplete <- bank_marketing
set.seed(123)
bank_incomplete$balance(sample(nrow(bank_incomplete), 300)) <- NA
m_bank <- glm(y ~ balance + housing + loan, data = bank_incomplete, family = binomial)
c(rows_in_data = nrow(bank_incomplete), rows_fitted = nobs(m_bank))
rows_in_data  rows_fitted
        4521         4221
Cu 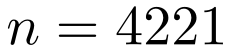 și modelul numai cu interceptare montat pe aceleași 4221 rânduri, cele două valori R² sunt:
Cod
n <- nobs(m_bank)
ll <- as.numeric(logLik(m_bank))
ll0 <- as.numeric(logLik(glm(y ~ 1, data = model.frame(m_bank), family = binomial)))
cox_snell <- 1 - exp((2 / n) * (ll0 - ll))
nagelkerke <- cox_snell / (1 - exp((2 / n) * ll0))
c(cox_snell = cox_snell, nagelkerke = nagelkerke)
 cox_snell nagelkerke
0.02278596 0.04455730
blr_rsq_cox_snell() şi blr_rsq_nagelkerke() returnează aceleași două valori și blr_model_fit_stats() le imprimă în tabelul cu statistici de potrivire:
Cod
blr_model_fit_stats(m_bank)
                               Model Fit Statistics
-----------------------------------------------------------------------------------
Log-Lik Intercept Only:     -1511.502    Log-Lik Full Model:              -1462.856
Deviance(4217):              2925.711    LR(3):                              97.292
                                         Prob > LR:                           0.000
MCFadden's R2                   0.032    McFadden's Adj R2:                   0.030
ML (Cox-Snell) R2:              0.023    Cragg-Uhler(Nagelkerke) R2:          0.045
McKelvey & Zavoina's R2:        0.067    Efron's R2:                          0.025
Count R2:                       0.884    Adj Count R2:                        0.000
BIC:                         2959.102    AIC:                              2933.711
-----------------------------------------------------------------------------------
În 0.3.2, modelul numai cu interceptare păstrează răspunsul modelului montat, decalajul și familia/legatura și n este nobs(model). Versiunile anterioare foloseau numărul de rânduri din cadrul de date, astfel încât valorile lipsă au tras ambele R² spre zero.
Ce să fac: reluați pseudo-R² pentru orice model cu date lipsă; noile valori sunt cele care se potrivesc cu definiţiile.
Indicele Gini este de acord cu AUC?
Indicele Gini este de obicei raportat alături de AUC în scoring credit, conform convenției 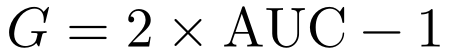 . Pentru modelul de marketing bancar de mai jos, curba ROC este:
Cod
m <- glm(y ~ duration + loan + housing + campaign, data = bank_marketing, family = binomial)
g <- blr_gains_table(m)
Cod
blr_roc_curve(g)
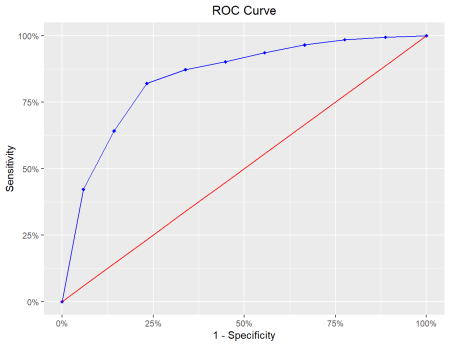
Figura 1: Curba ROC pentru modelul de marketing bancar.
Aria de sub acea curbă, calculată din rândurile probabilităților ajustate și indicele Gini sunt:
Cod
p <- fitted(m)
event <- bank_marketing$y == "1"
r <- rank(p)
n1 <- sum(event)
n0 <- sum(!event)
auc <- (sum(r(event)) - n1 * (n1 + 1) / 2) / (n1 * n0)
c(auc = auc, gini_from_auc = 2 * auc - 1, gini = blr_gini_index(m))
          auc gini_from_auc          gini
    0.8466918     0.6933835     0.6933835
Ultimele două numere sunt egale. În 0.3.2 blr_gini_index() calculează AUC din statistica de rang Mann-Whitney și returnează folosind doar rândurile pe care a fost montat modelul. Versiunile anterioare au returnat indicele de concentrație al probabilităților prezise, un număr diferit pentru același model, astfel încât un Gini raportat înainte de 0.3.2 nu poate fi comparat cu AUC. Formula de rang evită, de asemenea, debordarea pe modelele mari.
Tabelul de câștiguri din spatele curbei plasează acum fiecare observație exact într-unul din zece decile și numără evenimentele folosind nivelul de eveniment al răspunsului:
Cod
c(observations = sum(g$gains_table$total), events = sum(g$gains_table$`1`))
observations       events
        4521          517
Ce să fac: recalculați orice indice Gini și raportați-l ca de acum.
Testul raportului de probabilitate folosește gradele potrivite de libertate?
Un test al raportului de probabilitate compară un model complet cu unul redus. Gradele sale de libertate sunt diferența dintre numărul de parametri estimați, care este și diferența de grade de libertate reziduale.
job are 12 nivele, așa că adăugându-l la un model cu duration şi loan adaugă 11 parametri:
Cod
m_red <- glm(y ~ duration + loan, data = bank_marketing, family = binomial)
m_full <- glm(y ~ duration + loan + job, data = bank_marketing, family = binomial)
c(resid_df_reduced = m_red$df.residual, resid_df_full = m_full$df.residual)
resid_df_reduced    resid_df_full
            4518             4507
Testul folosește aceste două grade reziduale de libertate:
Cod
print(blr_test_lr(m_full, m_red))
    Likelihood Ratio Test
------------------------------
Chi-Square    DF    Pr > ChiSq
------------------------------
 86.2666      11      0.0000
------------------------------
Aceeași comparație în baza R dă aceeași devianță, grade de libertate și -valoare:
Cod
anova(m_red, m_full, test = "Chisq")
Analysis of Deviance Table

Model 1: y ~ duration + loan
Model 2: y ~ duration + loan + job
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1      4518     2644.9
2      4507     2558.7 11   86.267 8.951e-14 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
În 0.3.2 gradele de libertate provin din df.residual dintre cele două modele și -valoare din distribuţia chi-pătrat cu acele grade de libertate. Versiunile anterioare ar putea raporta grade greșite de libertate și, prin urmare, greșite -valoare, pentru modele imbricate cu predictori factori. Testul verifică, de asemenea, dacă modelul redus este imbricat în modelul complet, comparând spațiile de proiectare montate în loc să-l presupună.
Ce să fac: reluați testele cu raportul de probabilitate care implică predictori factori; o -valoarea dintr-o versiune anterioară poate fi bazată pe grade greșite de libertate.
Ce este nou din 2019?
Blorr se oprește când modelul nu este un logit binar?
testele și diagramele lui blorr presupun un răspuns binar cu o legătură logit. Versiunea 0.3.2 verifică modelul înainte de a calcula ceva, în loc să returneze un număr dintr-o potrivire pe care nu poate interpreta:
Cod
m_q <- glm(y ~ duration, data = bank_marketing, family = quasibinomial)
blr_regress(m_q)
Error:
! blorr supports binary logistic regression only (binomial family, logit link). This model uses the 'quasibinomial' family and the 'logit' link.
Aceeași gardă respinge greutățile anterioare, altele decât 1, răspunsurile binomiale grupate și potrivirile stocate fără cadrul sau răspunsul modelului, iar funcțiile de selecție resping aceste modele înainte de a remonta ceva.
Pot să desenez diagramele de validare în modul meu?
Datele din spatele curbei Lorenz și diagramei cu rata de captare în decili sunt exportate ca un cadru de date simplu. blr_prep_lorenz_data() returnează acțiunile cumulate de eveniment și non-eveniment; blr_prep_dcrate_data() returnează numărul decililor și media decilului:
Cod
head(blr_prep_lorenz_data(m), 4)
  cum_0s_per cum_1s_per
1 0.00000000  0.0000000
2 0.05844156  0.4216634
3 0.14285714  0.6421663
4 0.23276723  0.8201161
Cod
head(blr_prep_dcrate_data(g), 4)
  decile total   1 decile_mean
1      1   452 218  0.48230088
2      2   452 114  0.25221239
3      3   452  92  0.20353982
4      4   452  27  0.05973451
Ambele pot intra direct în ggplot2, plotly sau orice altă bibliotecă de plotting, cu gruparea și procentele deja calculate. Același lucru este valabil și pentru blr_prep_roc_data(), blr_prep_kschart_data() şi blr_prep_kschart_stat().
Alte îmbunătățiri
- Testul Hosmer–Lemeshow își ia gradele de libertate față de numărul observat de grupuri; modelul numai de interceptare din spatele statisticilor de potrivire păstrează răspunsul adaptat, offset-ul și familia/linkul; iar pornirea pachetului nu mai verifică rețeaua (#138, #129, #139).
blr_pairs()folosește contoare largi, astfel încât numărul de perechi peste limita întregului de 32 de biți nu mai depășește, iar gamma Somers’ D și Goodman-Kruskal folosesc numitorii corecti.- Proporțiile de descompunere a variației în
blr_eigen_cindex()suma la unu, iar indicii de condiție rămân finiți pentru proiecte de rang complet aproape coliniare. - Răspunsurile lipsă nu mai sunt considerate ca non-evenimente în segment, câștiguri, matrice de confuzie și rezumate de validare și rata evenimentelor în
blr_segment()şiblr_segment_dist()este ponderea evenimentelor din cadrul fiecărui nivel. blr_woe_iv()acceptă predictori de caractere și numerice, reduce nivelurile de factori neutilizate, aplică o corecție de continuitate de 0,5 nivelurilor fără evenimente sau fără evenimente și elimină rândurile cu valori lipsă.- Funcțiile AIC în trepte returnează acum un model numai de interceptare atunci când niciun predictor nu se califică.
Ce urmează
- Un răspuns cu trei niveluri este montat silențios, iar rezumatul răspunsului scade cu un nivel (#130). Verifica
nlevels()a răspunsului înainte de montare. Fix pe ramura de dezvoltare. - Devianța deltei în
blr_residual_diagnostics()folosește rezidualul Pearson standardizat la pătrat (#146). Fix pe ramura de dezvoltare. - Celulele de
blr_segment_twoway()sunt cota fiecărei celule din toate observațiile, nu rata evenimentelor din celulă. Pentru o rată în interiorul celulei, utilizațitapply(y, list(a, b), mean)(#152). blr_segment()şiblr_segment_dist()rotunjiți proporțiile la două zecimale înainte de a le folosi, astfel încât procentele și diagramele lor pot fi dezactivate cu până la jumătate de punct procentual (#153). Pentru acțiuni exacte, utilizațiprop.table(table(x))şitapply(y, x, mean).- Valoarea totală a informațiilor tipărită de
blr_woe_iv()adună valorile rotunjite pe nivel. Pentru un total precis, utilizați un număr mai maredigitsde exempludigits = 4(#155). - Un răspuns factor cu un singur nivel observat este tratat ca toate nonevenimentele de către funcțiile de segment și ponderea probei. Verificați dacă ambele clase sunt prezente mai întâi (#154).
Remedierile pentru #152–#155 sunt în ramura de dezvoltare. blorr 0.3.3, cu toate aceste remedieri, este planificat după 2027-01-13.
Mulțumiri
Mulțumesc tuturor celor care au contribuit la blorr începând cu postarea din 2019, deschizând probleme, raportând erori și trimițând solicitări de extragere: @aravindhebbali, @DrMedfaresBrini, @Irazall, @LuiNov, @paleolimbot și @romainfrancois.
