(Acest articol a fost publicat pentru prima dată pe R un blogși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta problema legată de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
Configurarea conductei
{pipeflow} construiește o conductă adăugând o funcție R pe pas cu
pip_add (vezi și articolul Începeți). În această postare, vom lucra cu următoarea conductă de jucării:
- pas
loadproduce o succesiune - pas
cleanîl dublează - pas
fitînsumează, și - pas
reportformatează rezultatul
pip <- pip_new("my-pip") |>
    pip_add(
        step = "load",
        fun = (n = 5) seq_len(n),
        tags = c("io", "daily")
    ) |>
    pip_add(
        step = "clean",
        fun = (x = ~load) x * 2,
        tags = c("io", "core")
    ) |>
    pip_add(
        step = "fit",
        fun = (x = ~clean) sum(x),
        tags = c("model", "core")
    ) |>
    pip_add(
        step = "report",
        fun = (x = ~fit) paste("result:", x),
        tags = "report"
    )
Fiecare pas trebuie să aibă un nume unic, iar parametrii funcției se pot referi la alți pași — de exemplu, x = ~load ia ieșirea lui încărca pas. De asemenea, atribuim tags la fiecare pas, pe care îl vom folosi pentru a filtra pașii mai târziu.
Înainte de a-l rula, să aruncăm o privire:
pipmy-pip (4 steps) --------------------------- step params depends state tags 1: load n new io,daily 2: clean x load new io,core 3: fit x clean new model,core 4: report x fit new report --------------------------- last run: never
Vedem un rând pe pas, arătându-și parametrii (params), pașii de care depinde (depends), curentul său state (toate new înainte de prima alergare), iar noastre tags. Odată ce rulăm conducta,…
pip_run(pip) info (2026-10-03 09:36:44.793 UTC): Starting run of pipeflow 'my-pip' info (2026-10-03 09:36:44.794 UTC): Step 1/4 load info (2026-10-03 09:36:44.795 UTC): Step 2/4 clean info (2026-10-03 09:36:44.797 UTC): Step 3/4 fit info (2026-10-03 09:36:44.799 UTC): Step 4/4 report info (2026-10-03 09:36:44.803 UTC): Finished run of pipeflow 'my-pip' pipmy-pip (4 steps) --------------------------- step params depends state out tags 1: load n done 1,2,3,4,5 io,daily 2: clean x load done 2, 4, 6, 8,10 io,core 3: fit x clean done 30 model,core 4: report x fit done result: 30 report --------------------------- last run: 2026-10-03 11:36:44
… există ceva nou out coloană cu rezultatele, care poate fi accesată și direct:
pip(("report", "out"))
(1) "result: 30"
Vizualizări pipeline în acțiune
Conductele reale devin lungi și adesea vă pasă doar de un subset de pași: un subiect, o etapă sau pașii care produc rezultatele dorite. Vizualizările (nou în v0.4.0) vă permit să lucrați la un astfel de subset fără a copia nimic. Ei fac referire la conducta de bază, astfel încât fiecare operațiune aplicată acesteia – rularea acestuia, actualizarea parametrilor, colectarea rezultatelor, … – scrie în conducta originală, limitată la pașii acoperiți de vizualizare.
Crearea vederilor
pip_view() returnează o vizualizare care conține numai pașii care se potrivesc cu filtrele date:
pip_view(pip, tags = "core")my-pip view (2 of 4 steps) ------------------------------------------ step params depends state out tags 1: clean x load done 2, 4, 6, 8,10 io,core 2: fit x clean done 30 model,core ------------------------------------------ last run: 2026-10-03 11:36:44 pip_view(pip, tags = "core", state = "done") my-pip view (2 of 4 steps) ------------------------------------------ step params depends state out tags 1: clean x load done 2, 4, 6, 8,10 io,core 2: fit x clean done 30 model,core ------------------------------------------ last run: 2026-10-03 11:36:44 pip_view(pip, step = c("clean", "fit")) my-pip view (2 of 4 steps) ------------------------------------------ step params depends state out tags 1: clean x load done 2, 4, 6, 8,10 io,core 2: fit x clean done 30 model,core ------------------------------------------ last run: 2026-10-03 11:36:44
În mod implicit, pașii trebuie să se potrivească toate filtre (ȘI logic), în timp ce valorile dintr-un filtru sunt alternative (OR).
join = "union" păstrează pașii care se potrivesc cu orice filtru și
fixed = FALSE tratează valorile filtrului ca expresii regulate:
pip_view(pip, tags = "report", step = "clean", join = "union")my-pip view (2 of 4 steps) ------------------------------------------ step params depends state out tags 1: clean x load done 2, 4, 6, 8,10 io,core 2: report x fit done result: 30 report ------------------------------------------ last run: 2026-10-03 11:36:44 pip_view(pip, step = "^f", fixed = FALSE) my-pip view (1 of 4 steps) ------------------------------------------ step params depends state out tags 1: fit x clean done 30 model,core ------------------------------------------ last run: 2026-10-03 11:36:44
Selectarea pașilor cu (
Operatorul de extragere (de asemenea, nou în v0.4.0) oferă o modalitate asemănătoare cu data.table de selectare a pașilor și returnează o vizualizare în mod implicit:
pip(c("load", "fit"))
 my-pip view (2 of 4 steps)
------------------------------------------
   step params depends state       out       tags
1: load      n          done 1,2,3,4,5   io,daily
2:  fit      x   clean  done        30 model,core
------------------------------------------
 last run: 2026-10-03 11:36:44
Filtrele booleene sunt evaluate în contextul tabelului de etape.
pip(tags %like% "core")my-pip view (2 of 4 steps) ------------------------------------------ step params depends state out tags 1: clean x load done 2, 4, 6, 8,10 io,core 2: fit x clean done 30 model,core ------------------------------------------ last run: 2026-10-03 11:36:44 pip(step %in% c("clean", "fit") & state == "done") my-pip view (2 of 4 steps) ------------------------------------------ step params depends state out tags 1: clean x load done 2, 4, 6, 8,10 io,core 2: fit x clean done 30 model,core ------------------------------------------ last run: 2026-10-03 11:36:44
Vederi de alergare
Rularea unei vizualizări execută pașii pe care îi acoperă împreună cu orice dependențe din amonte care nu sunt actualizate. Jurnalul de rulare marchează propriii pași ai vizualizării ca (view) iar dependenţele trase ca (upstream):
pip_reset(pip)  # reset the pipeline to "new" state for demonstration
pip_run(pip_view(pip, step = "report"))
info (2026-10-03 09:36:44.883 UTC): Starting run of pipeflow 'my-pip view'
info (2026-10-03 09:36:44.883 UTC): Step 1/4 (upstream) load
info (2026-10-03 09:36:44.883 UTC): Step 2/4 (upstream) clean
info (2026-10-03 09:36:44.884 UTC): Step 3/4 (upstream) fit
info (2026-10-03 09:36:44.885 UTC): Step 4/4 (view) report
info (2026-10-03 09:36:44.886 UTC): Finished run of pipeflow 'my-pip view'
Ulterior, conducta originală este actualizată pentru pașii acoperiți. Să colectăm toate rezultatele legate de pașii „de bază”:
pip(tags %like% "core") |> pip_collect()
$clean
(1)  2  4  6  8 10

$fit
(1) 30
Pentru un ghid complet despre compunerea vizualizărilor, consultați vigneta vizualizărilor pipeline.
Mai multe funcții noi și actualizate
Vizualizările sunt doar una dintre completări. Fiecare dintre următoarele are propriul articol pe site-ul de documentare:
- API funcțional și în stilul metodei — pipeabilul
pip_*()funcții, cu fiecare funcție disponibilă și ca metodă (p$run(),p$view()…): Începeți. - Extrageți și înlocuiți operatorii — date.stil tabel
(şi((pentru pașii de citire și editare: referință. - Colectați și grupați rezultate —
pip_collect()cu grupare după etichete sau dependențe: colectați și grupați ieșirile. - Combinarea și modificarea conductelor — combinați mai multe conducte cu
rbind()sau înlocuiți, redenumiți, eliminați și resetați pașii: Combinați conductele · Modificați conductele existente. - Împărțiți, mapați și reduceți — nativ
exec = "split","auto"și
"reduce"moduri: Split, map, and reduce. - Conducte imbricate — utilizați o conductă ca bloc reutilizabil în cadrul unei etape: conducte imbricate.
- Conducte automodificabile —
.selfrestructurarea timpului de rulare șirestart(): Conducte automodificabile.
Sub capotă, au fost obținute câștiguri semnificative de performanță prin implementarea graficului de dependență în C++ (începând cu v0.3.0) și prin îmbunătățirea evidenței pasilor și parametrilor în {data.table} de bază. În cele din urmă, prin scăpare lgr şi jsonlitedependențele de pachete externe au fost reduse la {data.table} și Rcpp.
{pipeflow} vs {targets}
{targets} rămâne standardul de facto al lui R pentru conducte grele, reproductibile: persistă rezultatele pe disc, înregistrează proveniența și se extinde la infrastructura distribuită prin crew. {pipeflow} nu încearcă să concureze pe acel teren propriu, ci țintește o altă nișă – sesiunea interactivă, adesea ca backend-ul unei aplicații Shiny – unde o conductă este construită și modificată din mers și trebuie să răspundă în timp ce un utilizator așteaptă. Deoarece receptivitatea este esențială în acel caz de utilizare, {pipeflow} a fost optimizat pentru o latență scăzută.
Articolul pipeflow vs targets compară latența în sesiune a celor două pachete cap la cap. Figura de mai jos oferă o imagine a rezultatelor:

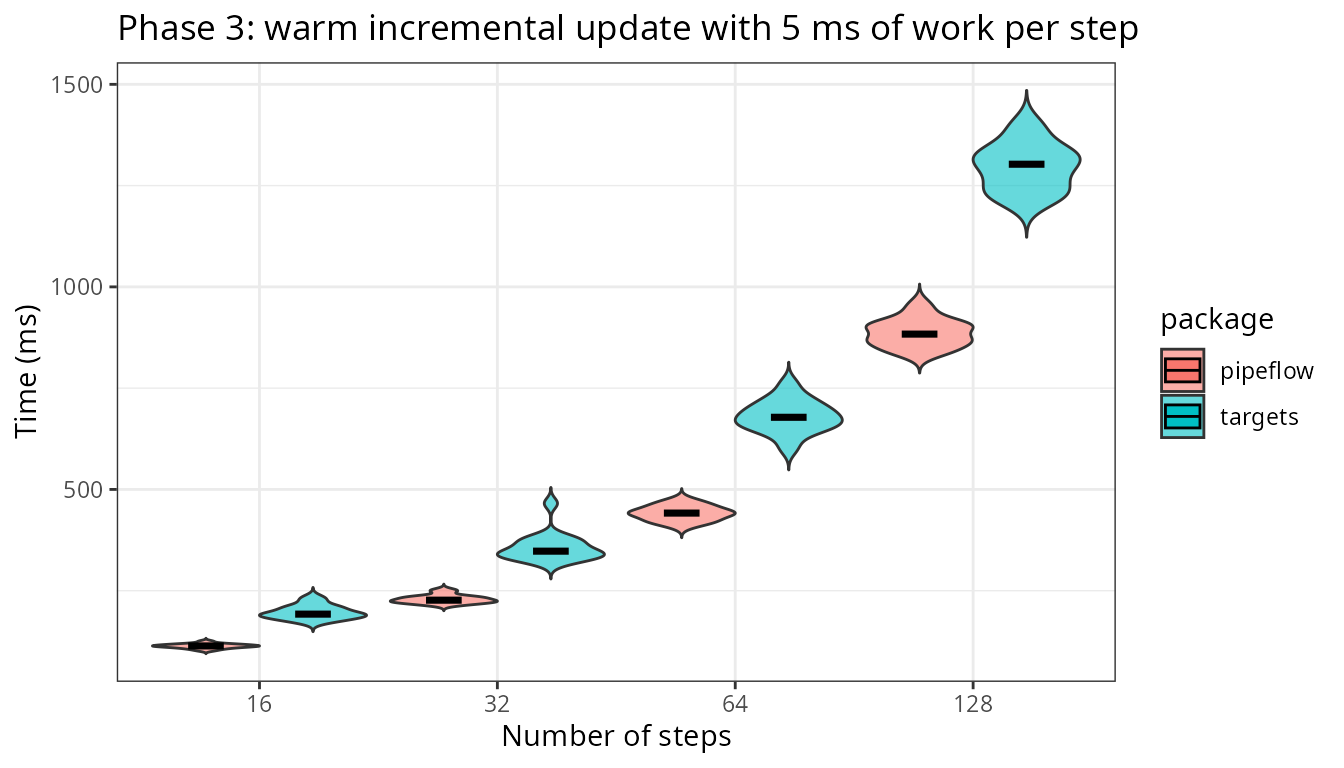
Acesta arată scenariul în care un parametru s-a schimbat și conducta este reluată, fiecare pas efectuând 5 ms de lucru. Axa x reprezintă numărul de pași din conductă (dimensiunea acestuia), iar axa y arată timpul necesar pentru a-l rula din nou.
Pe dimensiunile testate, {pipeflow} este în mod constant cel mai rapid dintre cele două – consultați articolul pentru referința și metodologia completă.
În general, cele două sunt privite cel mai bine ca fiind complementare: atingeți {targets} pentru lucrări de loturi mari care trebuie să fie reproductibile cap la cap și pentru {pipeflow} atunci când conducta face parte dintr-o aplicație interactivă.
Încheierea
{pipeflow} 0.4.0 este pe CRAN:
install.packages("pipeflow")
