Blogul lui Zhenguo Zhang https://fortune9.netlify.app/2026/10/23/python-simpsons-paradox/ –
Introducere
Paradoxul lui Simpson apare atunci când direcția unei asocieri se inversează după ce sunt combinate datele din mai multe grupuri. De exemplu, A poate avea o rată de succes mai mare decât B în fiecare subgrup, dar o rată de succes mai mică în general.
În această postare, vom simula rezultatele examenului în Python, vom examina inversarea folosind regresia logistică și o cifră plotnină și vom explica de ce se întâmplă. Tot codul Python este încorporat în acest document R Markdown și rulează prin reticulate.
Înființat
Puteți sări peste această secțiune dacă nu doriți să executați singur codul.
Folosim NumPy pentru a simula rezultatele, panda pentru a rezuma datele, modele statistice pentru a se potrivi modelelor de regresie logistică și plotnine pentru a crea figura. Pachetul R reticulate ne permite să rulăm cod Python în acest document. Dacă este necesar, instalați-l cu install.packages("reticulate").
Am folosit punctele Python către executabilul meu local la /mnt/windows/Program/ubuntu/pyenv/versions/3.13.9/bin/python. Pentru a găsi python3 executabil pe PATH, rulați:
Sys.which("python3")
Se utilizează fragmentul de configurare reticulate::use_python() pentru a selecta un anumit executabil Python. Înlocuiți calea cu executabilul pentru propria dvs. instalare Python sau mediu virtual înainte de a rula orice fragmente Python. Dacă RETICULATE_PYTHON variabila de mediu este setată, are prioritate use_python().
Instalați pachetele Python în același mediu. În comanda de mai jos, înlocuiți python cu executabilul ales, dacă este necesar:
python -m pip install numpy pandas plotnine
Veți avea nevoie și de modele de statistici pentru modelele de regresie de mai jos. Reticulate rulează toate bucățile Python într-o sesiune partajată, astfel încât obiectele create într-o singură bucată rămân disponibile în bucățile ulterioare.
Un exemplu simulat cu un factor de confuzie
Vom examina relația dintre programul de studiu și rata de promovare a examenului, cu dificultatea examenului ca factor de confuzie.
Elevii aparțin fie programului A, fie programului B și aleg între un examen ușor și un examen dificil. În mod deliberat, facem alegerile lor inegale: 90% dintre studenții din programul A aleg examenul greu, în timp ce 90% dintre studenții din programul B aleg examenul ușor.
Tabelul de mai jos oferă numărul de studenți și probabilitatea de promovare pentru fiecare combinație de dificultate de program și examen.
| O | Uşor | 1.000 | 90% |
| O | Greu | 9.000 | 40% |
| B | Uşor | 9.000 | 80% |
| B | Greu | 1.000 | 30% |
Folosind aceste dimensiuni și probabilități de grup, să simulăm un set de date de 20.000 de studenți. Fiecare rând reprezintă un elev, iar rezultatul este codificat ca 1 pentru o promovare sau 0 pentru un eșec.
Menținem dimensiunile grupurilor fixe și generăm rezultatul fiecărui elev în mod independent rng.binomial(1, p)unde p este probabilitatea de promovare pentru grupul respectivului elev. O sămânță aleatorie fixă face exemplul reproductibil.
import numpy as np
import pandas as pd
# Fixed group sizes; independently simulate each student's pass/fail outcome.
rng = np.random.default_rng(2026)
design = (
    ("Easy", "A", 1000, 0.90),
    ("Easy", "B", 9000, 0.80),
    ("Hard", "A", 9000, 0.40),
    ("Hard", "B", 1000, 0.30),
)
df = pd.concat(
    (
        pd.DataFrame({
            "difficulty": difficulty,
            "program": program,
            "passed": rng.binomial(1, probability, size=n),
        })
        for difficulty, program, n, probability in design
    ),
    ignore_index=True,
)
Iată primele câteva rânduri ale setului de date simulat:
print(df.head())
  difficulty program  passed
0       Easy       A       1
1       Easy       A       1
2       Easy       A       1
3       Easy       A       1
4       Easy       A       1
Putem verifica numărul de elevi din fiecare grupă:
df(("program","difficulty")).value_counts().reset_index(name="Count")
  program difficulty  Count
0       A       Hard   9000
1       B       Easy   9000
2       A       Easy   1000
3       B       Hard   1000
Examinați ratele de promovare în datele simulate
Mai întâi, să potrivim un model de regresie logistică cu program ca singurul predictor al promovării unui elev.
import statsmodels.formula.api as smf
logit_fit = smf.logit("passed ~ C(program)", data=df).fit(disp=False)
print(logit_fit.summary())
                           Logit Regression Results
==============================================================================
Dep. Variable:                 passed   No. Observations:                20000
Model:                          Logit   Df Residuals:                    19998
Method:                           MLE   Df Model:                            1
Date:                Sun, 25 Oct 2026   Pseudo R-squ.:                 0.07323
Time:                        22:15:47   Log-Likelihood:                -12511.
converged:                       True   LL-Null:                       -13499.
Covariance Type:            nonrobust   LLR p-value:                     0.000
===================================================================================
                      coef    std err          z      P>|z|      (0.025      0.975)
-----------------------------------------------------------------------------------
Intercept          -0.2322      0.020    -11.534      0.000      -0.272      -0.193
C(program)(T.B)     1.3197      0.031     43.140      0.000       1.260       1.380
===================================================================================
Coeficientul pentru programul B, raportat la programul A, este 1,3197 pe scara log-cote. Acest coeficient pozitiv indică faptul că studenții din programul B au o probabilitate mai mare de promovare. Valoarea p mică arată că asocierea este semnificativă statistic.
Acum să adăugăm la model dificultatea examenului:
logit_fit_with_confounder = smf.logit("passed ~ C(program) + C(difficulty)", data=df).fit(disp=False)
print(logit_fit_with_confounder.summary())
                           Logit Regression Results
==============================================================================
Dep. Variable:                 passed   No. Observations:                20000
Model:                          Logit   Df Residuals:                    19997
Method:                           MLE   Df Model:                            2
Date:                Sun, 25 Oct 2026   Pseudo R-squ.:                  0.1441
Time:                        22:15:47   Log-Likelihood:                -11554.
converged:                       True   LL-Null:                       -13499.
Covariance Type:            nonrobust   LLR p-value:                     0.000
=========================================================================================
                            coef    std err          z      P>|z|      (0.025      0.975)
-----------------------------------------------------------------------------------------
Intercept                 1.8555      0.059     31.210      0.000       1.739       1.972
C(program)(T.B)          -0.4760      0.058     -8.185      0.000      -0.590      -0.362
C(difficulty)(T.Hard)    -2.2809      0.059    -38.892      0.000      -2.396      -2.166
=========================================================================================
După ce luăm în considerare dificultatea examenului, coeficientul pentru programul B devine negativ. Modelul indică acum că studenții din programul B au o probabilitate mai mică de a promova decât studenții din programul A atunci când dificultatea examenului este menținută constantă.
Pentru a vedea direct inversarea, să comparăm ratele de promovare din cadrul fiecărui grup de dificultate cu ratele generale pentru fiecare program:
by_group = (
    df.groupby(("difficulty", "program"))("passed")
    .agg(n="size", passes="sum", rate="mean")
    .reset_index()
)
pooled = (
    df.groupby("program")("passed")
    .agg(n="size", passes="sum", rate="mean")
    .reset_index()
)
print("Within difficulty groups:")
print(by_group.to_string(index=False, float_format="%.4f"))
print("nAll students combined:")
print(pooled.to_string(index=False, float_format="%.4f"))
Within difficulty groups:
difficulty program    n  passes   rate
      Easy       A 1000     886 0.8860
      Easy       B 9000    7169 0.7966
      Hard       A 9000    3536 0.3929
      Hard       B 1000     310 0.3100

All students combined:
program     n  passes   rate
      A 10000    4422 0.4422
      B 10000    7479 0.7479
Trasarea acestor rate una lângă alta face ca inversarea să fie ușor de văzut. Primele două panouri compară programe din cadrul fiecărui grup de dificultate; a treia combină toți studenții:
from plotnine import (
    aes, facet_wrap, geom_col, geom_text, ggplot, labs,
    scale_fill_manual, scale_y_continuous, theme, theme_minimal,
)

plot_data = pd.concat(
    (by_group, pooled.assign(difficulty="Combined")), ignore_index=True
)
plot_data("difficulty") = pd.Categorical(
    plot_data("difficulty"), categories=("Easy", "Hard", "Combined"), ordered=True
)
plot_data("label") = plot_data("rate").map(lambda rate: f"{rate:.1%}")

plot = (
    ggplot(plot_data, aes(x="program", y="rate", fill="program"))
    + geom_col(width=0.65)
    + geom_text(aes(label="label"), va="bottom", nudge_y=0.02, size=10)
    + facet_wrap("difficulty", nrow=1)
    + scale_fill_manual(values={"A": "#0072B2", "B": "#D55E00"})
    + scale_y_continuous(
        limits=(0, 1), breaks=(0, 0.25, 0.5, 0.75, 1),
        labels=lambda values: (f"{value:.0%}" for value in values),
    )
    + labs(
        title="Simpson's paradox: the comparison reverses when groups are pooled",
        subtitle="Program A has a higher pass rate in each difficulty group",
        x="Program", y="Pass rate",
        caption="Simulated data: A has 90% hard cases; B has 90% easy cases.",
    )
    + theme_minimal(base_size=12)
    + theme(legend_position="none", figure_size=(10, 4))
)
plot.show()
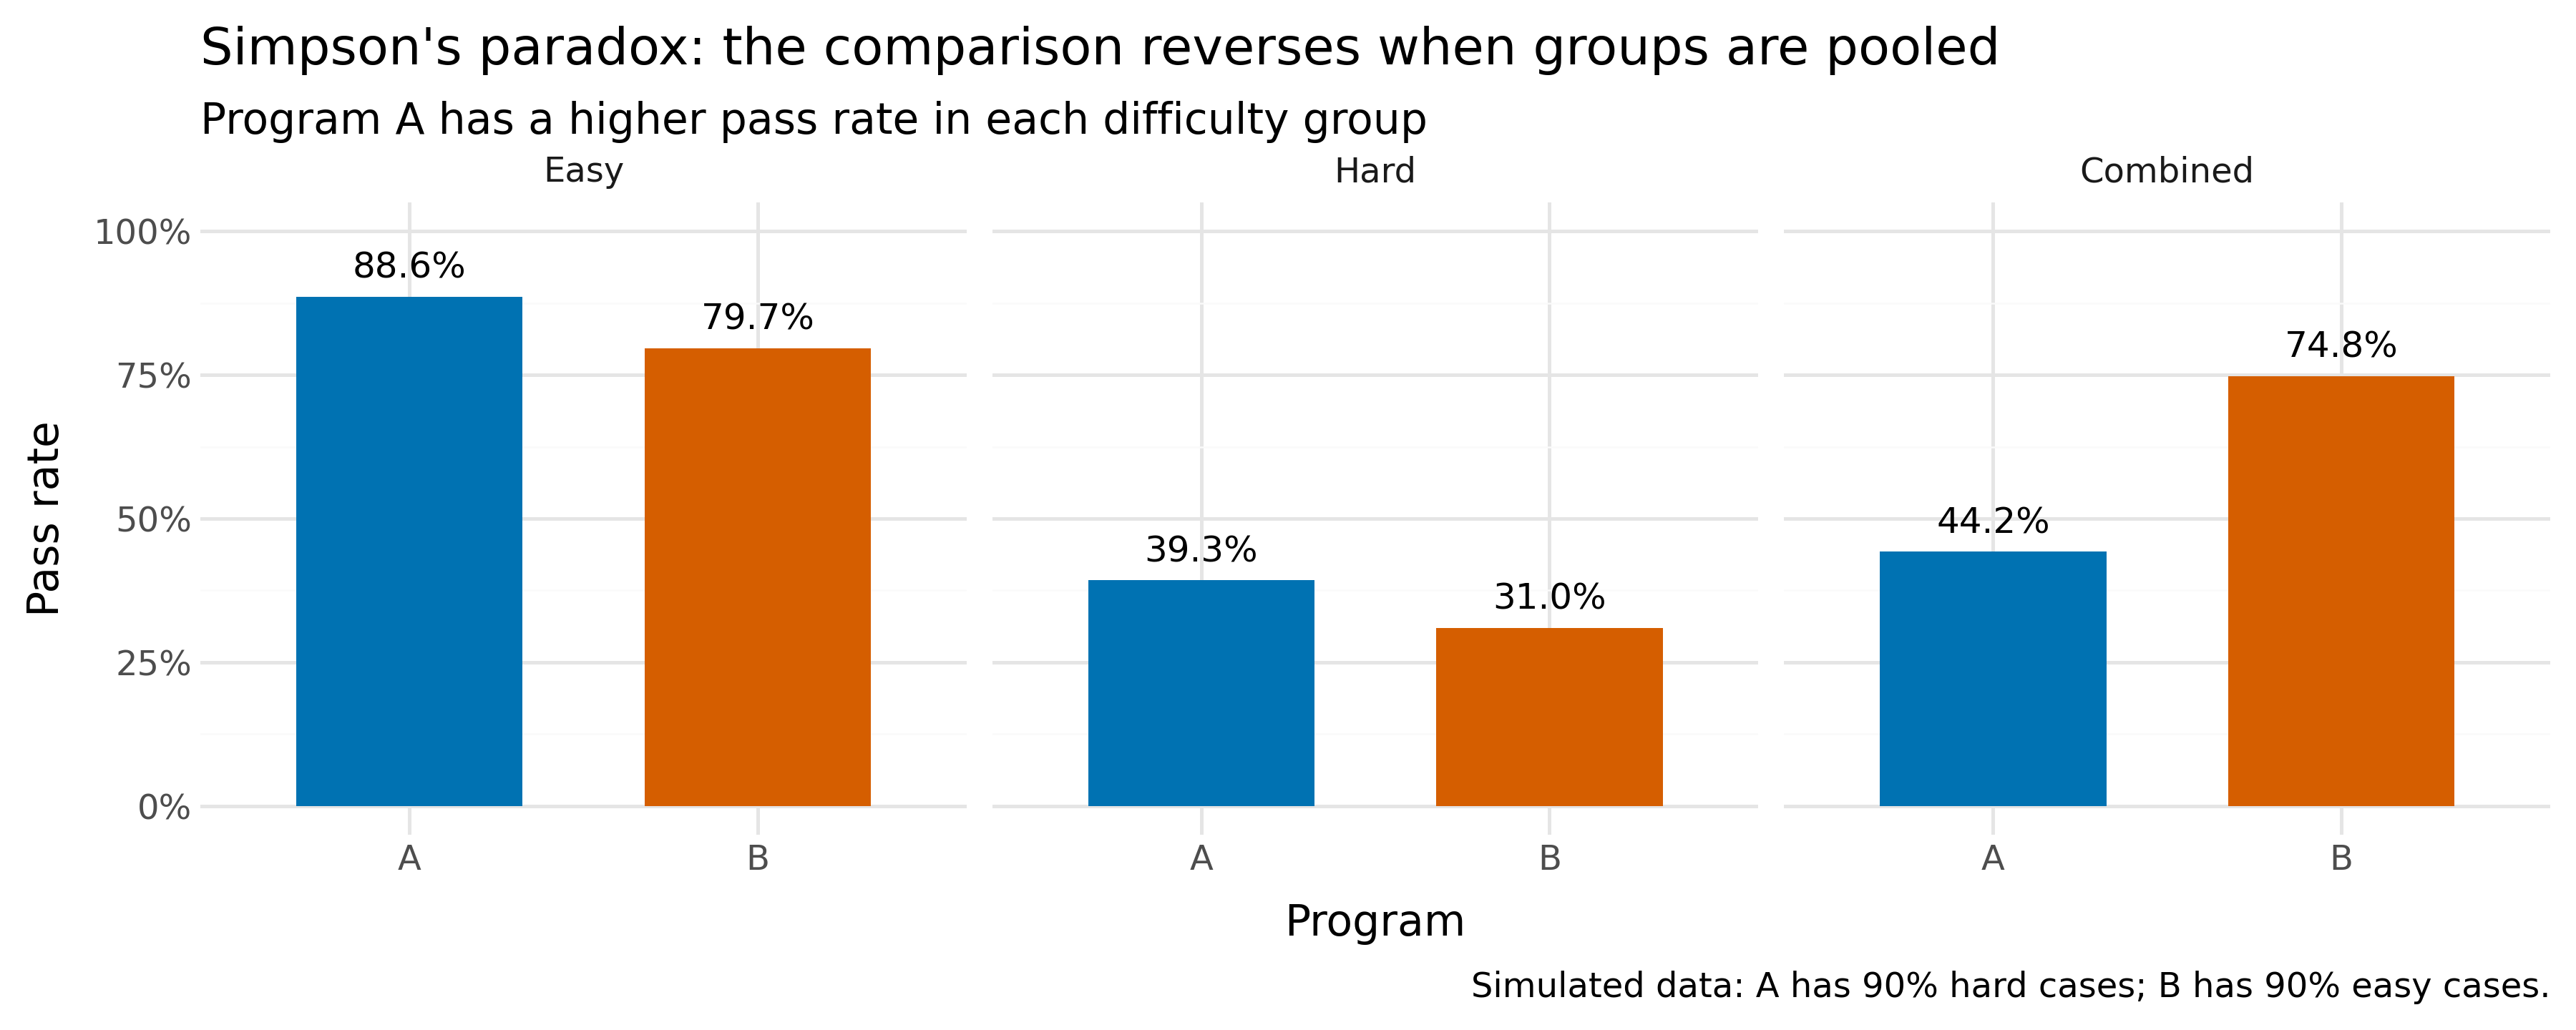
Figura 1: Ratele de promovare în cadrul grupurilor de dificultate și după gruparea studenților.
De ce combinarea grupurilor schimbă rezultatul
Rata generală de promovare a fiecărui program este o medie ponderată a ratelor de promovabilitate la examenele simple și dificile. Greutățile sunt proporțiile studenților care susțin fiecare examen în cadrul programului respectiv.
Pentru programul A, 10% dintre studenți susțin examenul ușor și 90% susțin examenul greu. Prin urmare, rata de promovabilitate globală este:
A: (1,000 / 10,000) × (886 / 1,000)
 + (9,000 / 10,000) × (3,536 / 9,000)
 = 0.4422 = 44.22%
Pentru programul B proporțiile sunt inversate: 90% susțin examenul ușor și 10% susțin examenul greu. Rata generală de promovare este:
B: (9,000 / 10,000) × (7,169 / 9,000)
 + (1,000 / 10,000) × (310 / 1,000)
 = 0.7479 = 74.79%
A are o rată de promovare mai mare la fiecare nivel de dificultate, dar majoritatea studenților săi susțin examenul greu. B are o rată de promovare mai mică la fiecare nivel de dificultate, dar majoritatea studenților săi susțin examenul ușor. Pentru că tarifele subgrupului primesc greutăți diferitecomparația generală îl favorizează pe B.
Inversarea este deja prezentă în probabilitățile pe care le-am specificat, înainte de a simula orice rezultat. Folosind aceste probabilități, ratele generale de promovare așteptate sunt:
A: 0.10 × 0.90 + 0.90 × 0.40 = 0.45
B: 0.90 × 0.80 + 0.10 × 0.30 = 0.75
Eșantionarea aleatorie introduce variații în jurul acestor rate așteptate. Inversarea în sine vine din combinația dintre probabilitățile de promovare și distribuția neuniformă a dificultății examenului între programe.
Dificultatea face confuzie aici
În această simulare, studenții din programul A au mai multe șanse să aleagă examene dificile decât studenții din programul B. Dificultatea examenului este, prin urmare, asociată cu apartenența la program și afectează, de asemenea, probabilitatea de promovare. Joacă rolul unui factor de confuzie: ignorând-o amestecă asocierea dintre program și promovare cu diferențe în dificultatea examenului. Luarea în considerare a dificultăților ne permite să comparăm programele dintre studenții care susțin examene de aceeași dificultate.
O inversare singură nu stabilește un efect cauzal și nu ne spune pentru ce variabile să ne ajustăm. Aceste decizii necesită ipoteze cu privire la modul în care variabilele se raportează. De exemplu, condiționarea unui ciocnitor poate introduce părtinire. Prin urmare, împărțirea datelor în subgrupe pe baza fiecărei variabile disponibile nu este o soluție generală.
La pachet
- Paradoxul lui Simpson apare atunci când o asociere indică în aceeași direcție în cadrul fiecărui subgrup, dar se inversează atunci când grupurile sunt combinate.
- Examinați dimensiunile grupurilor, precum și ratele: diferențele în compoziția grupului determină ponderile în comparația generală.
- Utilizați cunoștințele despre procesul de generare a datelor pentru a ghida interpretarea cauzală și ajustarea.
– https://fortune9.netlify.app/2026/10/23/python-simpsons-paradox/ –
