(Acest articol a fost publicat pentru prima dată pe Data Science Gutsși cu amabilitate a contribuit la R-bloggeri). (Puteți raporta probleme legate de conținutul acestei pagini aici)
Doriți să vă distribuiți conținutul pe R-bloggeri? dați clic aici dacă aveți un blog, sau aici dacă nu aveți.
În 2020, am antrenat un U-Net pe nucleele Data Science Bowl din 2018 cu prima versiune a acestui pachet, am urmărit urcarea unui scor de zaruri în timpul antrenamentului și am terminat postarea cu patru măști prezise pe imaginile de test ale competiției. Acele imagini nu au măști. Imaginile arătau bine și nu aveam de unde să știu unde a greșit modelul – așa că nu am întrebat niciodată.
Această postare întreabă. Nimic din el nu se antrenează: modelul este cel publicat dsbowl-unet din primul post al seriei, punctat pe imaginile din care a fost ținut. Punerea la punct a tuturor a durat aproximativ douăsprezece secunde pe un procesor.
Imaginile din care a fost ținută
Datele sunt BBBC038v1 de la Broad Institute – imaginile Data Science Bowl sub o derogare CC0. Sale stage1_train deține 670 de imagini adnotate, câte un director fiecare, cu câte un fișier masca pe nucleu.
data_dir <- "stage1_train" # BBBC038v1, unzipped
data_dir = "stage1_train" # BBBC038v1, unzipped
Greutățile au fost măsurate pe o împărțire 80/20 din toate cele 670 la sămânța 1, astfel încât împărțirea să poată fi făcută din nou. split_dataset() nu copiază nimic; scrie fișiere CSV care listează fișierele:
library(rplatypus)

split <- split_dataset(data_dir, tempfile("splits"),
                       fractions = c(0.8, 0.2), seed = 1)
split
#> platypus split
#>   train        536 samples
#>   validation   134 samples
#>   every sample its own group
#>   seed 1 - the same inputs give this split again
import tempfile
import pyplatypus as pp

split = pp.split_dataset(data_dir, tempfile.mkdtemp(),
                         fractions=(0.8, 0.2), seed=1)
split("samples")
#> {'train': 536, 'validation': 134, 'test': 0}
A face din nou despărțirea contează mai mult decât pare. Propria mea copie a acestui set de date are un director numit stage1_validation cu exact 134 de imagini în el – același număr – și 101 dintre ele sunt în partea de antrenament a diviziunii pe care au fost măsurate greutățile. Punctat acolo, modelul ar fi evaluat parțial pe imaginile din care a învățat, iar numărul nu ți-ar spune niciodată.
Un singur număr
spec <- platypus_spec(
  data = segmentation_data(split, colormap = binary_colormap),
  models = list(
    u_net("nuclei", input_shape = c(256, 256), blocks = 4, filters = 16,
          weights = "dsbowl-unet", fit = FALSE,
          metrics = list(metric_dice(include_background = FALSE)))
  )
)
fit <- platypus_fit(spec, verbose = FALSE)

cases <- evaluate_cases(fit)
summary(cases)
#>   metric   n      mean         sd    median       min       max
#> 1   dice 134 0.9205236 0.05322748 0.9313503 0.7239583 0.9860661
#>                                                         worst_case
#> 1 7f38885521586fc6011bef1314a9fb2aa1e4935bd581b2991e1d963395eab770
engine = pp.build_engine(pp.from_dict({
    "task": "semantic_segmentation",
    "data": {
        "train_path": str(split("paths")("train")),
        "validation_path": str(split("paths")("validation")),
        "colormap": ((0, 0, 0), (255, 255, 255)),
        "mode": "config_file",
    },
    "models": ({
        "name": "nuclei",
        "architecture": "u_net",
        "input_shape": (256, 256),
        "blocks": 4,
        "filters": 16,
        "weights": "dsbowl-unet",
        "fit": False,
        "metrics": ({"name": "dice", "include_background": False}),
    }),
}))
engine.fit()

cases = engine.evaluate_cases("nuclei")
pp.summarise_cases(cases)
#> ({'metric': 'dice', 'n': 134, 'mean': 0.9205236150257623,
#>   'sd': 0.05322747958922138, 'median': 0.9313502907752991,
#>   'min': 0.7239583134651184, 'max': 0.9860661029815674,
#>   'worst_case':
#>     '7f38885521586fc6011bef1314a9fb2aa1e4935bd581b2991e1d963395eab770'})
Un zar mediu de 0,9205 și cea mai proastă imagine la 0,7240 – numerele cardului model la patru cifre, care este verificarea că aceasta este împărțirea cărții. include_background = FALSE menține fundalul în afara mediei; cu el încorporat, un model care nu a găsit deloc nuclee ar avea în continuare aproximativ jumătate.
0,92 este un număr bun și este adevărat. Întrebarea este care este media de.
Un rând pe imagine
evaluate() oferă un rând pe model. evaluate_cases() oferă un rând pe imagine și acesta este tabelul care merită citit:
head(cases(order(cases$dice), ), 5)
#> platypus scores by case (5 rows)
#>                                                              case      dice
#>  7f38885521586fc6011bef1314a9fb2aa1e4935bd581b2991e1d963395eab770 0.7239583
#>  29ea4f6eb4545f43868a9b40a60000426bf8dfd9d062546656a37bd2a2aaf9ec 0.7531800
#>  8f94a80b95a881d0efdec36affc915dca9609f4cba8134c4a91b219d418778aa 0.7541562
#>  a6515d73077866808ad4cb837ecdac33612527b8a1041e82135e40fce2bb9380 0.7588775
#>  2a1a294e21d76efd0399e4eb321b45f44f7510911acd92c988480195c5b4c812 0.7702851
worst = sorted(cases, key=lambda row: row("dice"))(:5)
((row("case")(:16), round(row("dice"), 4)) for row in worst)
#> (('7f38885521586fc6', 0.724), ('29ea4f6eb4545f43', 0.7532),
#>  ('8f94a80b95a881d0', 0.7542), ('a6515d7307786680', 0.7589),
#>  ('2a1a294e21d76efd', 0.7703))
Aceste nume nu spun nimic, așa că dă fiecărei imagini o etichetă. Data Science Bowl a amestecat trei tipuri de microscopie și două numere le deosebesc suficient de bine: dacă imaginea are culoare și dacă fundalul este deschis sau întunecat.
image_kind <- function(case) {
  path <- list.files(file.path(data_dir, case, "images"), full.names = TRUE)
  pixels <- png::readPNG(path(1))(, , 1:3)
  colour <- mean(abs(pixels(, , 1) - pixels(, , 2))) +
    mean(abs(pixels(, , 2) - pixels(, , 3)))
  if (colour > 0.02) return("stained")
  if (mean(pixels) > 0.5) "brightfield" else "fluorescence"
}
cases$kind <- vapply(cases$case, image_kind, character(1))

aggregate(dice ~ kind, cases, function(x) {
  round(c(n = length(x), mean = mean(x), min = min(x)), 3)
})
#>           kind  dice.n dice.mean dice.min
#> 1  brightfield   3.000     0.749    0.724
#> 2 fluorescence 105.000     0.935    0.753
#> 3      stained  26.000     0.883    0.805
from pathlib import Path
import numpy as np
from PIL import Image

def image_kind(case):
    path = next((Path(data_dir) / case / "images").glob("*.png"))
    pixels = np.asarray(Image.open(path).convert("RGB")) / 255
    colour = (np.abs(pixels(..., 0) - pixels(..., 1)).mean()
              + np.abs(pixels(..., 1) - pixels(..., 2)).mean())
    if colour > 0.02:
        return "stained"
    return "brightfield" if pixels.mean() > 0.5 else "fluorescence"

for row in cases:
    row("kind") = image_kind(row("case"))

kinds = sorted({row("kind") for row in cases})
dice = {k: (r("dice") for r in cases if r("kind") == k) for k in kinds}
{k: (len(d), round(float(np.mean(d)), 3), round(min(d), 3))
 for k, d in dice.items()}
#> {'brightfield': (3, 0.749, 0.724), 'fluorescence': (105, 0.935, 0.753),
#>  'stained': (26, 0.883, 0.805)}
library(ggplot2)
ggplot(cases, aes(dice, kind)) +
  geom_vline(xintercept = mean(cases$dice), linetype = "dashed",
             colour = "grey50") +
  geom_jitter(height = 0.15, width = 0, alpha = 0.7, size = 2) +
  labs(x = "Dice, per image", y = NULL) +
  theme_minimal(base_size = 13)
import matplotlib.pyplot as plt

rng = np.random.default_rng(1)
fig, ax = plt.subplots(figsize=(7, 3.2))
ax.axvline(np.mean((r("dice") for r in cases)), linestyle="--", color="grey")
for i, k in enumerate(kinds):
    jitter = rng.uniform(-0.15, 0.15, len(dice(k)))
    ax.scatter(dice(k), i + jitter, alpha=0.7)
ax.set_yticks(range(len(kinds)), kinds)
ax.set_xlabel("Dice, per image")
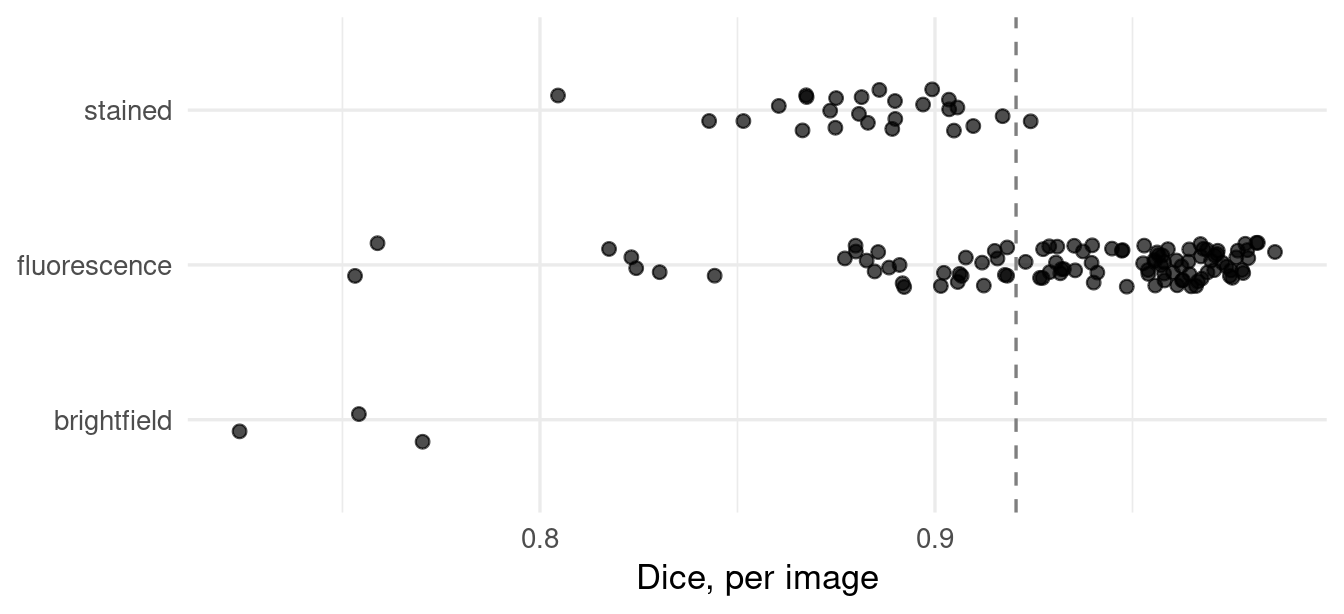
Figura 1: zaruri pentru fiecare dintre cele 134 de imagini reținute. Linia întreruptă este media.
Există trei imagini în câmp luminos printre cele 134 și au nota 0,72, 0,75 și 0,77 – trei dintre cele mai proaste cinci. Fluorescența este în medie de 0,93 peste 105 imagini și este cea mai mare parte a ceea ce măsoară media. Țesutul pătat se află între cele două, la 0,88.
predictions <- predict(fit, split = "validation")

files_of <- function(case, what) {
  list.files(file.path(data_dir, case, what), full.names = TRUE)
}
truth_of <- function(case) {
  masks <- lapply(files_of(case, "masks"), function(f) {
    read_masks(f, binary_colormap, size = c(256, 256))(1, , )
  })
  unite_masks(masks)
}

middle <- which.min(abs(cases$dice - median(cases$dice)))
shown <- c(which(cases$kind == "brightfield"), middle)
images <- read_images(
  vapply(cases$case(shown), function(k) files_of(k, "images")(1), ""),
  size = c(256, 256)
)
truth <- simplify2array(lapply(cases$case(shown), truth_of))

plot_masks(
  images,
  prediction = predictions(shown, , ),
  truth      = aperm(truth, c(3, 1, 2)),
  colormap   = binary_colormap,
  labels     = sprintf("%s, Dice %.2f", cases$kind(shown), cases$dice(shown))
)
predictions = engine.predict("nuclei", "validation")
data = engine.dataset(engine.runs("nuclei").spec, "validation")

middle = np.median((r("dice") for r in cases))
shown = (i for i, r in enumerate(cases) if r("kind") == "brightfield")
shown.append(min(range(len(cases)),
                 key=lambda i: abs(cases(i)("dice") - middle)))

pp.plot_masks(
    np.stack((data(i)(0) for i in shown)),
    prediction=predictions(shown),
    truth=np.stack((data(i)(1) for i in shown)),
    labels=(f"{cases(i)('kind')}, Dice {cases(i)('dice'):.2f}"
            for i in shown),
)

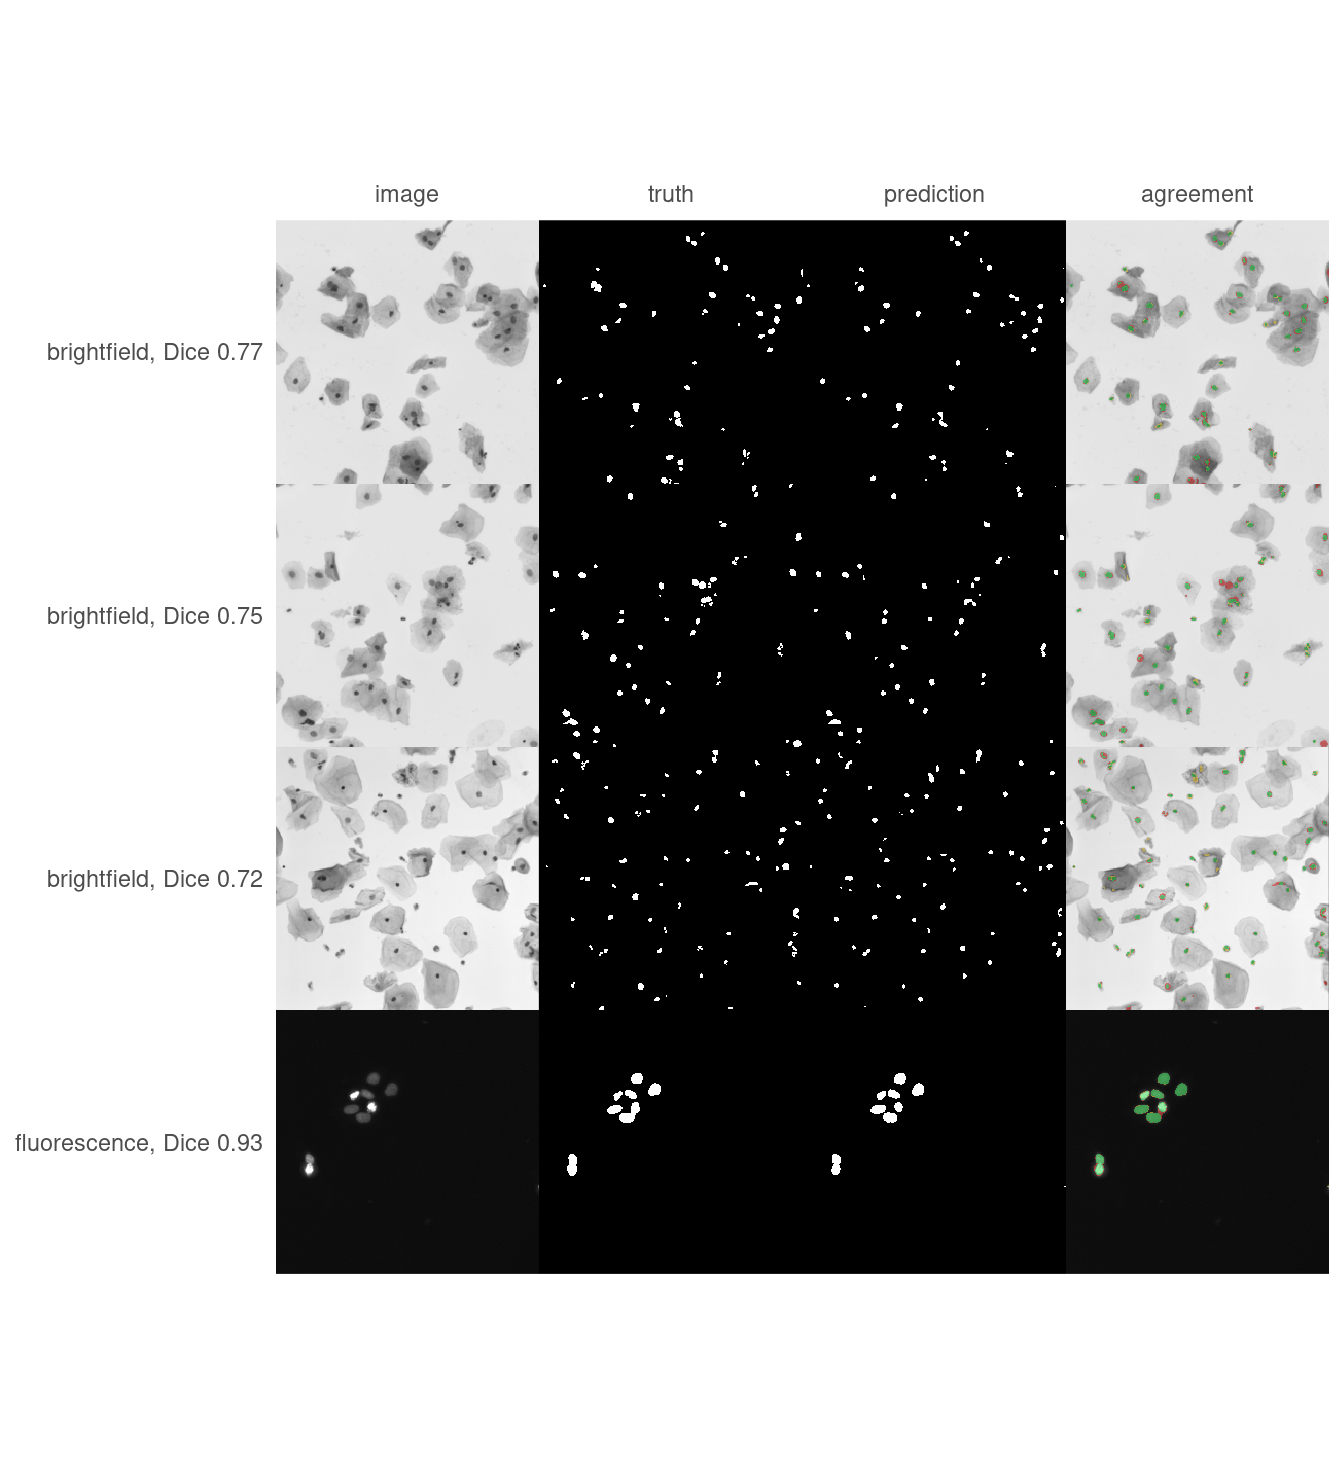
Figura 2: Cele trei imagini cu câmp luminos și o imagine cu fluorescență de la mijlocul clasamentului. În ultima coloană este găsit verde, roșu este ratat și galben este inventat.
Genul de microscop sau dimensiunea unui nucleu?
Imaginile sugerează o a doua lectură. Imaginile de câmp luminos sunt de 1024 x 1024 pixeli, iar modelul vede fiecare imagine la 256 x 256 – deci un nucleu de șaisprezece pixeli ajunge la patru. Măsurați nucleul mediu pe grila modelului:
nucleus_area <- function(case) {
  files <- list.files(file.path(data_dir, case, "masks"), full.names = TRUE)
  areas <- vapply(files, function(f) {
    sum(read_masks(f, binary_colormap) == 2)
  }, numeric(1))
  size <- dim(read_masks(files(1), binary_colormap))(2:3)
  mean(areas) * 256^2 / prod(size)
}
cases$area <- vapply(cases$case, nucleus_area, numeric(1))

aggregate(area ~ kind, cases, function(x) round(range(x)))
#>           kind area.1 area.2
#> 1  brightfield     11     17
#> 2 fluorescence     69    957
#> 3      stained    137   1893
def nucleus_area(case):
    files = sorted((Path(data_dir) / case / "masks").glob("*.png"))
    masks = (np.asarray(Image.open(f)) > 0 for f in files)
    height, width = masks(0).shape(:2)
    return np.mean((m.sum() for m in masks)) * 256**2 / (height * width)

for row in cases:
    row("area") = nucleus_area(row("case"))

areas = {k: (r("area") for r in cases if r("kind") == k) for k in kinds}
{k: (round(min(a)), round(max(a))) for k, a in areas.items()}
#> {'brightfield': (11, 17), 'fluorescence': (69, 957),
#>  'stained': (137, 1893)}
Pe orice altă imagine, un nucleu mediu acoperă cel puțin 69 de pixeli ai grilei. Pe cele trei imagini cu câmp luminos, acoperă unsprezece până la șaptesprezece. Deci, cele trei imagini sunt atât singurul câmp luminos din divizare, cât și singurele în care nucleele sunt atât de mici, și trei imagini nu pot deosebi aceste două explicații. Nici antrenamentul nu ajută: dintre cele 536 de imagini de antrenament, 13 sunt în câmp luminos, toate 1024 cu 1024 de asemenea.
Nici notarea la rezoluția proprie a fișierelor nu le separă, deoarece detaliul s-a pierdut înainte de a fi luat scorul – predicția a fost făcută la 256:
summary(evaluate_cases(fit, at = "source"))
#>   metric   n     mean         sd    median       min       max
#> 1   dice 134 0.920808 0.05371718 0.9313503 0.7164674 0.9860661
#>                                                         worst_case
#> 1 7f38885521586fc6011bef1314a9fb2aa1e4935bd581b2991e1d963395eab770
pp.summarise_cases(engine.evaluate_cases("nuclei", at="source"))
#> ({'metric': 'dice', 'n': 134, 'mean': 0.920808045276955,
#>   'sd': 0.053717183966230486, 'median': 0.9313502907752991,
#>   'min': 0.7164673805236816, 'max': 0.9860661029815674,
#>   'worst_case':
#>     '7f38885521586fc6011bef1314a9fb2aa1e4935bd581b2991e1d963395eab770'})
Ceea ce i-ar separa este un model care vede aceste imagini la o rezoluție în care un nucleu este la fel de mare ca oriunde în altă parte – placare în loc de redimensionare, care este o postare proprie mai târziu în serie.
Ce să ia din asta
Media nu a fost greșită. 0,92 este valoarea acestui model pe aceste 134 de imagini. Dar este în mare parte o medie de peste 105 de imagini cu fluorescență, iar cele trei imagini pe care le face cel mai rău împărtășesc două proprietăți simultan, oricare dintre acestea ar putea fi cauza. Nimic din toate acestea nu este vizibil într-un număr; toate acestea sunt vizibile într-un tabel cu un rând pe imagine și o coloană pe care o adăugați singur.
Dacă raportați un scor de segmentare, raportați cel mai rău caz lângă medie și vedeți ce au în comun cele mai rele cazuri. Aici a fost nevoie de un apel de funcție și câteva linii de R sau Python.
Seria de pana acum
- rplatypus reconstruit: învățare profundă pentru imagini medicale în R – de ce a trebuit rescris pachetul 2020, cum își instalează acum propriul Python și o primă mască din aceleași greutăți publicate folosite aici.
- Nuclei, cinci ani mai târziu – această postare.
Următorul rămâne cu segmentare, dar face un pas înapoi de la un singur set de date: ce oferă rplatypus pentru el – patru arhitecturi și cum diferă, pierderile și valorile din care puteți alege și fișierul YAML care descrie un întreg experiment, câmp cu câmp.
